

Introducción
Cuando el atacante ya irrumpió en la red corporativa, las siguientes etapas del ataque suelen incluir el uso de los protocolos estándar de la infraestructura de dominio: interacción con Kerberos, consultas DNS, acceso a servicios internos, carpetas de red y otras acciones comunes. Esta actividad casi no se distingue del tráfico de red legítimo, por lo que su detección mediante los medios clásicos de identificación de ataques de red resulta mucho más difícil.
El Kerberoasting y la tunelización de DNS ya no son técnicas inusuales. Hoy se han convertido en métodos estándar en los ataques modernos, ya que permiten a los atacantes ejecutar etapas críticas del ataque mientras permanecen poco visibles para las defensas tradicionales. Encontramos confirmación regular de esta tendencia en campañas recientes, en las que se aplican en la práctica tanto el Kerberoasting como la tunelización de DNS.
Las herramientas clásicas de defensa de red funcionan bien cuando el ataque tiene un indicador estable y reconocible: una cadena característica en la solicitud, un patrón conocido de tráfico malicioso o el código fuente de un exploit. Este enfoque de detección de amenazas sigue siendo eficaz, pero no siempre resulta aplicable para la búsqueda de ataques de red que se confunden con el tráfico legítimo en la red corporativa.
En lugar de buscar indicadores explícitos de ataque, la tecnología NAD (Network Anomaly Detection) analiza todo el tráfico en busca de señales sospechosas que no corresponden a la actividad de red típica del host. Entre las soluciones de Kaspersky, esta tecnología la implementa, en particular, la plataforma Kaspersky Anti Targeted Attack (KATA).
El sistema analiza los datos de los paquetes de tráfico de red (por ejemplo, DNS, DCE/RPC, Kerberos, entre otros) y extrae de ellos parámetros importantes, utilizados para identificar comportamiento anómalo. Este enfoque permite buscar ataques a controladores de dominio, indicios de tunelización y exfiltración de tráfico, comunicación C2 y otros escenarios que pueden indicar un compromiso de la infraestructura de red.
Sin embargo, la tecnología de búsqueda de anomalías de red no se basa, por sí sola, en un conjunto universal de indicadores. Cada escenario de ataque utiliza sus propios modelos de detección, que consideran las particularidades del protocolo de red correspondiente, el comportamiento típico de los hosts y las desviaciones características respecto a él. En este artículo, analizamos dos ejemplos prácticos (la detección de Kerberoasting y de tunelización de DNS) para mostrar cómo se aplican estos principios en las reglas NAD de KATA y por qué este enfoque resulta más eficaz que el análisis clásico por firmas.
Detección del ataque Kerberoasting en KATA
Por qué el Kerberoasting es difícil de detectar con herramientas estándar
El ataque Kerberoasting se basa en la lógica estándar de funcionamiento del protocolo Kerberos. El atacante localiza cuentas de servicio con el identificador Service Principal Name (SPN), solicita para ellas un ticket TGS (Ticket-Granting Service) e intenta descubrir la contraseña utilizando el ticket obtenido y un ataque de diccionario. Si la contraseña es débil o no se ha cambiado en mucho tiempo, el atacante puede obtenerla en texto claro mediante fuerza bruta. Después, las credenciales comprometidas pueden usarse para el movimiento vertical y lateral dentro de la red.
El ataque de Kerberoasting consiste en que el delincuente, al contar con una cuenta comprometida de privilegios bajos y con un ticket TGT válido (Ticket-Granting Ticket) para esa cuenta, puede solicitar tickets TGS con cifrado debilitado para cuentas de servicio con SPN. En este caso, no importa si la cuenta comprometida tiene o no permisos de acceso a ese servicio. Al obtener estos tickets, el atacante puede descifrarlos de forma local, sin actividad de red, mediante prueba de contraseñas. De esta manera, obtiene el hash de la contraseña de la cuenta de servicio.
El objetivo del atacante es encontrar una cuenta de servicio con contraseña simple. Lo más probable es que se trate de una cuenta creada de forma manual por los administradores de la infraestructura o de un servicio específico. Por eso, a los atacantes no les interesan las cuentas de servicio del sistema con SPN (por ejemplo, CIFS/fileserver.company.local), ya que se crean de forma automática y tienen contraseñas muy complejas, imposibles de descubrir mediante fuerza bruta.
Cabe destacar que las solicitudes de tickets TGS realizadas por los atacantes no se diferencian de las solicitudes habituales. En cualquier dominio siempre habrá bastante tráfico Kerberos. Esta es la principal dificultad para detectar el Kerberoasting: las solicitudes legítimas de tickets de servicio (TGS-REQ) son indistinguibles de las de los atacantes. Por eso, el principal método de detección es la correlación de indicios indirectos, y no la búsqueda por firmas. Los principales indicadores son: origen anómalo de la solicitud (host o cuenta atípicos), aumento brusco en el número de SPN solicitados en un intervalo de tiempo corto, intentos de obtención de tickets de servicio para cuentas de servicio sensibles o privilegiadas, así como horario y cantidad de solicitudes fuera de lo habitual en comparación con el perfil histórico del usuario y del host de destino.
La tecnología NAD permite detectar la mayoría de estos indicios, lo que ayuda al analista a pasar de un gran volumen de tráfico Kerberos a una hipótesis concreta: quién pudo haber iniciado el ataque Kerberoasting, qué cuentas de servicio quedaron en riesgo y por qué esa actividad difiere de la actividad habitual.
En el ataque analizado, la anomalía de red consiste en que, en un intervalo de tiempo corto, un solo host, es probable que usando una sola cuenta (cname), obtiene tickets TGS ("msg_type": "KRB_TGS_REP") para múltiples servicios únicos con SPN (sname). Estas cuentas de servicio no son del sistema.
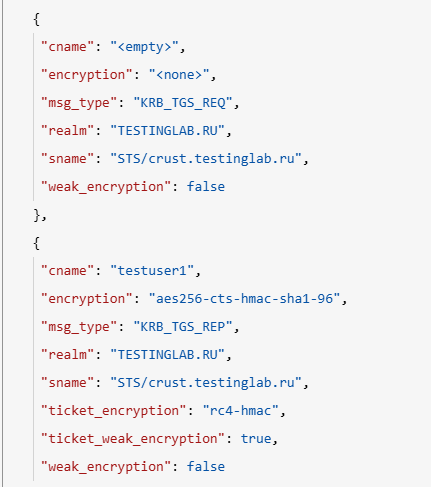
Ejemplo de par de eventos de solicitud TGS-REQ y respuesta TGS-REP en los atributos de la sesión de red
Para detectar esta anomalía, la regla NAD “Indicios de ataque Kerberoasting” sigue la siguiente lógica:
- Entre las sesiones de red por el protocolo Kerberos, en el período igual a la profundidad de búsqueda de la regla, se seleccionan solo aquellas en las que se obtuvo una respuesta Kerberos TGS-REP exitosa. En este caso, deben cumplirse las siguientes condiciones:
- la dirección IP desde la que se inició la sesión no debe estar excluida en la variable
excl_sip; - el nombre del cliente que envió la solicitud (
cname) no debe figurar en la lista de usuarios excluidos (variableexcl_users); - el SPN (
sname) no debe estar excluido en la propia regla. Los SPN del sistema quedan excluidos de la lógica. Están presentes en la mayoría de las infraestructuras y no resultan de interés para los atacantes en este tipo de ataque; sin embargo, si se contabilizan en el total de SPN únicos, pueden generar un falso positivo en la regla al superar el umbral definido.
- la dirección IP desde la que se inició la sesión no debe estar excluida en la variable
- De esas sesiones se extraen el
cname(nombre del cliente que envió el TGS-REQ) y elsname(el propio SPN). - Las sesiones se agrupan por la dirección IP de origen de la solicitud y el nombre de la cuenta del cliente (
cname), agregando sesiones con SPN únicos. - Si, para una misma dirección IP con una misma cuenta de cliente, dentro del período igual a la profundidad de búsqueda, se obtienen respuestas TGS-REP para N nombres de SPN únicos (donde N es mayor o igual al valor de la variable de umbral
count_spns), se genera una alerta. - Durante el período igual al tiempo de resolución de repetición del evento, todas las alertas posteriores relacionadas con la misma dirección IP del cliente se combinarán en la primera alerta. Esto evita la creación de nuevos eventos, aumentando en su lugar el contador de agregación de alertas (indicador “Total de apariciones”).
Cabe señalar que esta lógica no puede implementarse mediante firmas de IDS. Supongamos que creamos una regla de Suricata para detectar paquetes Kerberos del tipo TGS-REP. Para evitar falsos positivos, excluimos de la firma la lista de SPN del sistema con contraseñas complejas y establecemos un umbral para la cantidad de estas respuestas recibidas por un mismo cliente. Sin embargo, una regla de este tipo no puede tener en cuenta la unicidad de los nombres de SPN; solo queda basarse en el número de paquetes. Por eso, la cantidad de falsos positivos para esta firma será muy alta, ya que en cualquier dominio habrá numerosos mensajes TGS-REP legítimos idénticos.
Además, es mucho más práctico agregar excepciones y modificar los umbrales para adaptar la lógica a la infraestructura mediante variables personalizadas en la interfaz, que editar la estructura de la regla de IDS.
Creación de una regla de detección de anomalías de red
Las reglas de la tecnología NAD se representan como consultas SQL a la base de datos de KATA basada en ClickHouse. A continuación, mostramos cómo agregar y poner en funcionamiento una regla de este tipo.
Para comenzar a trabajar con las reglas de la tecnología NAD, es necesario ir a la sección de la interfaz “Reglas personalizadas”, subapartado “Detección de intrusiones”. En la pestaña “Detección de anomalías de red” se puede agregar una nueva regla.
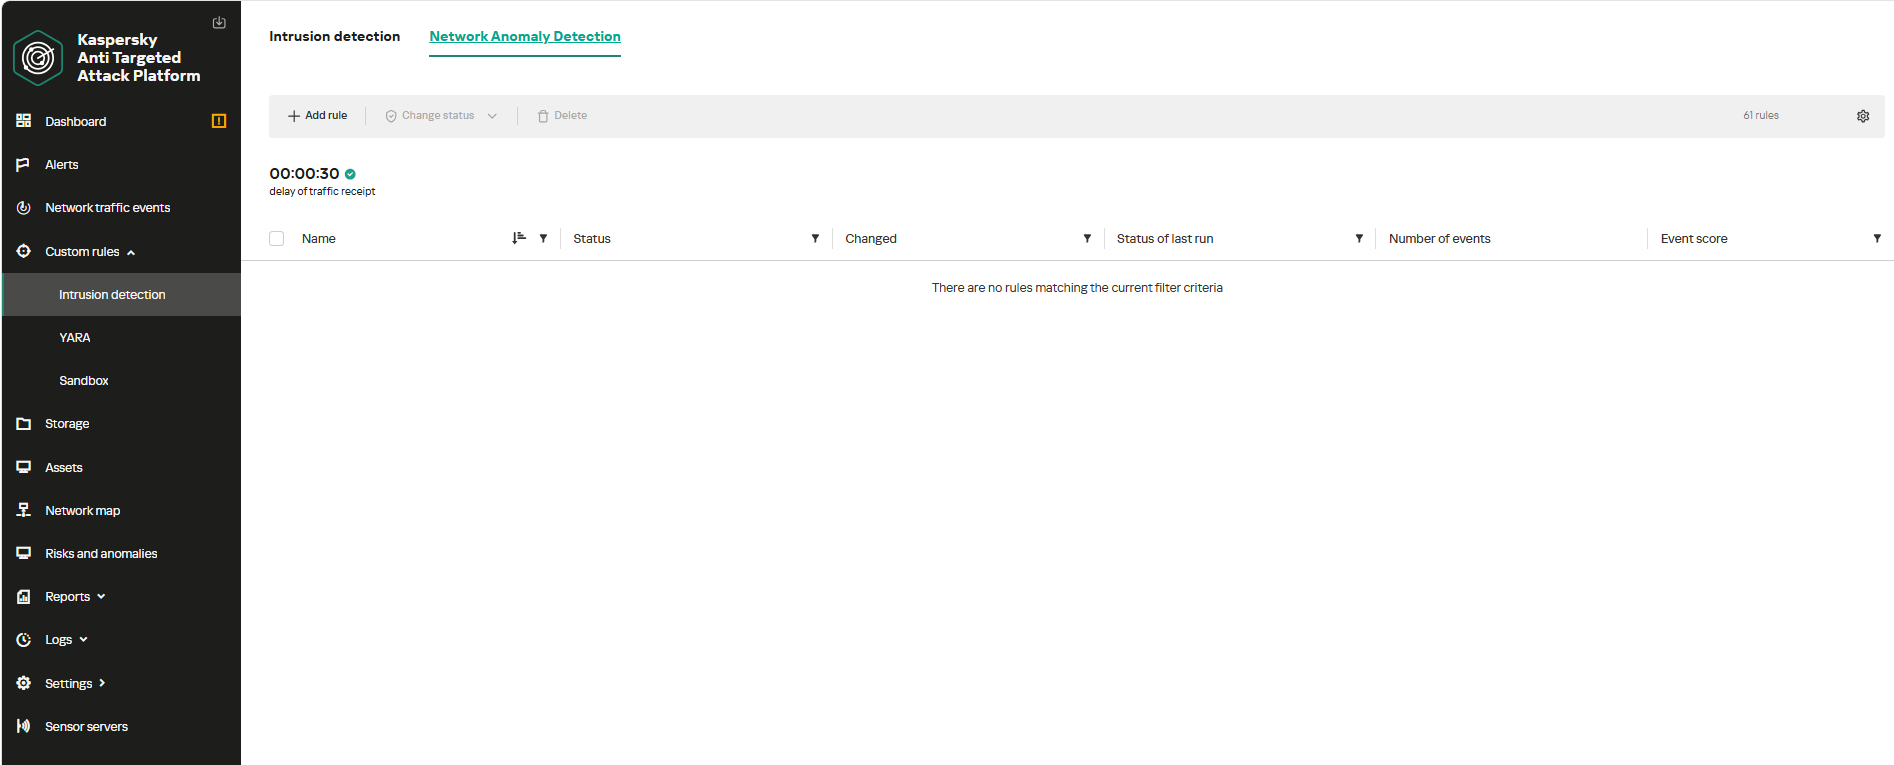
Interfaz de la página “Detección de anomalías de red”
Al agregar una nueva regla, es posible seleccionar la plantilla de regla deseada entre las plantillas listas para usar, que se entregan con el producto junto con las actualizaciones.
Además, el analista puede modificar de forma manual la regla agregada a partir de la plantilla (en este caso, pasará a considerarse personalizada, mientras que la plantilla en sí permanece sin cambios) o crear la suya propia desde cero, siguiendo las instrucciones.
Al seleccionar una plantilla, el analista puede ver la descripción de la regla, además de modificar o dejar en su valor estándar los siguientes parámetros:
- profundidad de búsqueda (intervalo de tiempo a partir del momento actual dentro del cual se ejecutará la consulta SQL);
- programación (periodicidad de ejecución de la consulta con la profundidad de búsqueda antes indicada);
- tiempo de resolución de repetición del evento (período dentro del cual las alertas similares se agregan en una sola, en lugar de mostrarse como nuevas).
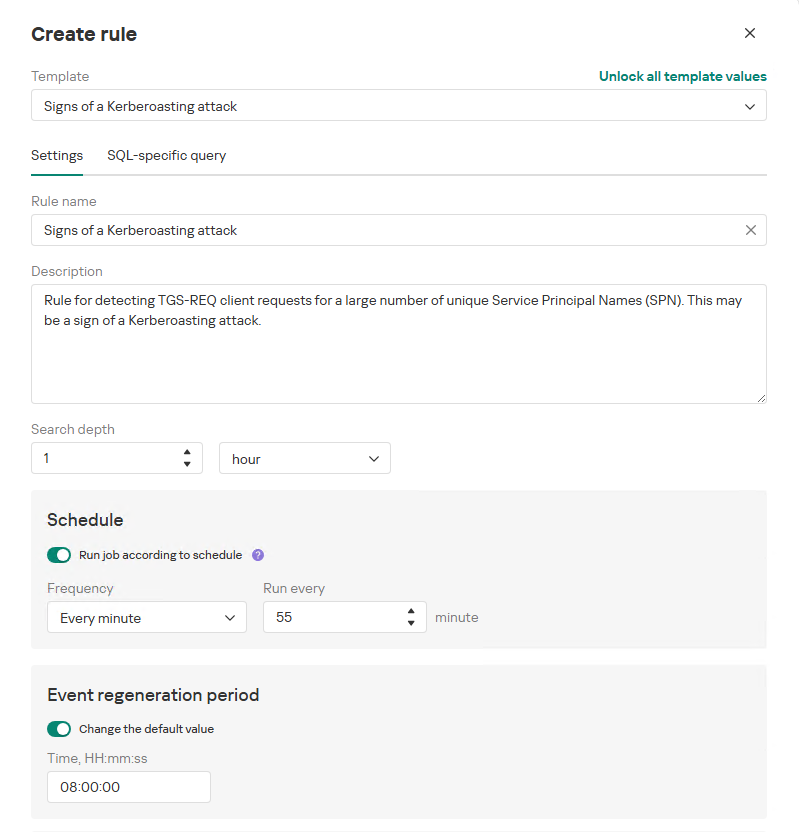
Interfaz de creación de una nueva regla NAD
Para el correcto funcionamiento de la regla, recomendamos que, antes de activarla, acceda a la pestaña “Consulta SQL” y revise las variables utilizadas en la regla (la descripción de cada variable está disponible al colocar el cursor sobre el signo de interrogación).
Las variables corresponden a diversas listas, compuestas por direcciones IP, fechas, cadenas y valores numéricos, que describen la infraestructura de red: controladores de dominio, servidores DNS, rangos de tiempo, segmentos críticos y otras entidades. Esta funcionalidad permite adaptar cada regla a diferentes entornos de red, considerando las particularidades de la infraestructura sin modificar la lógica.
En nuestro ejemplo, mediante variables, la regla “Indicios de ataque Kerberoasting” puede configurarse de la siguiente manera, sin modificar la propia consulta SQL:
- excluir del ámbito de verificación la dirección IP de origen de las solicitudes TGS-REQ (aquí se puede indicar un único valor, una máscara de subred o un catálogo con la lista de direcciones y máscaras), así como la cuenta del cliente que envía la solicitud (se admite un único valor o un catálogo con varios valores);
- modificar el valor de umbral para la generación de alertas según la cantidad de SPN únicos en los mensajes TGS-REQ.
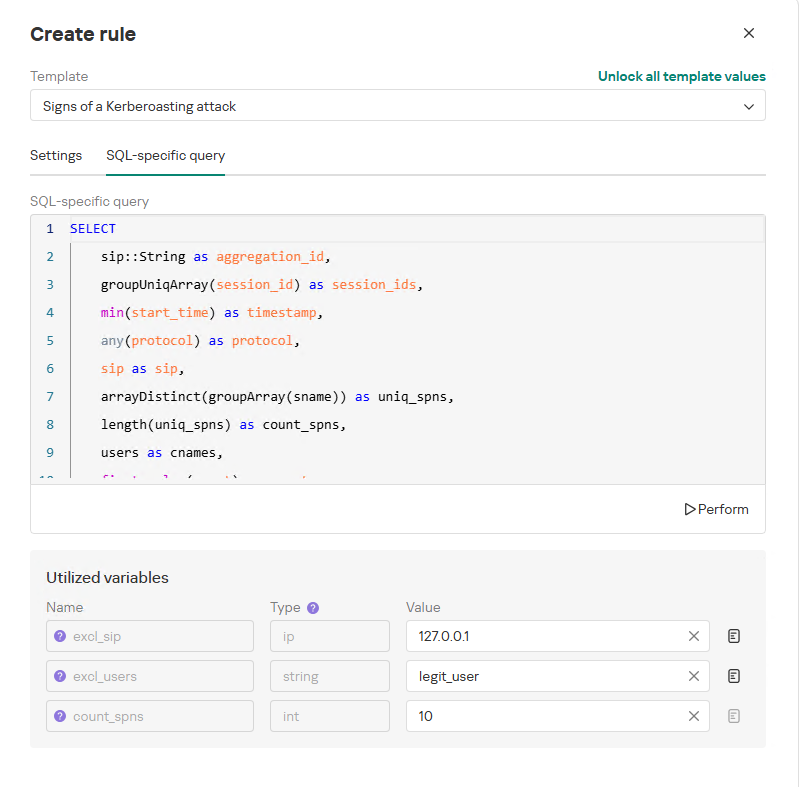
Contenido de la consulta y variables utilizadas en la nueva regla
En esa misma página, es posible verificar el funcionamiento de la regla antes de guardarla.
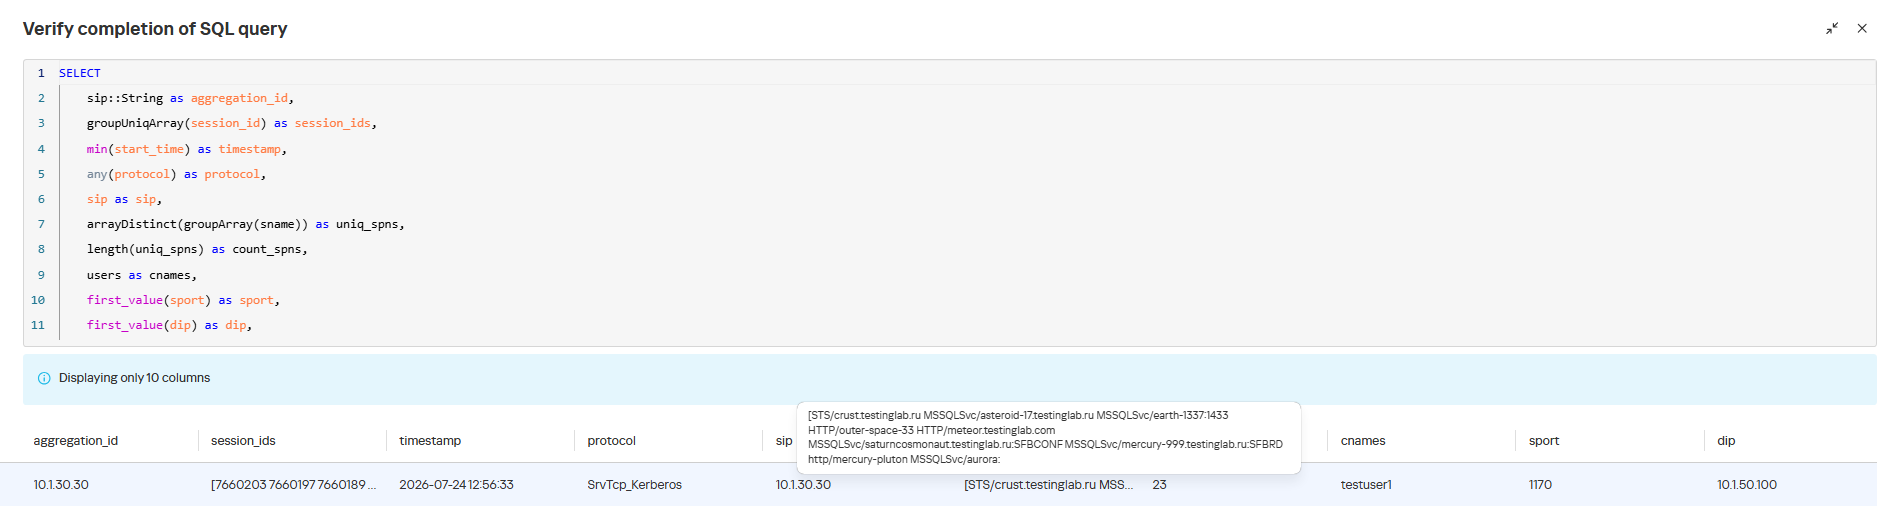
Resultado de la verificación de funcionamiento de la regla
Cuando esta regla se activa, se genera una alerta del tipo NDR:NAD. En la tarjeta de la alerta, el analista visualiza información básica: direcciones IP, puertos y los participantes de la interacción de red.
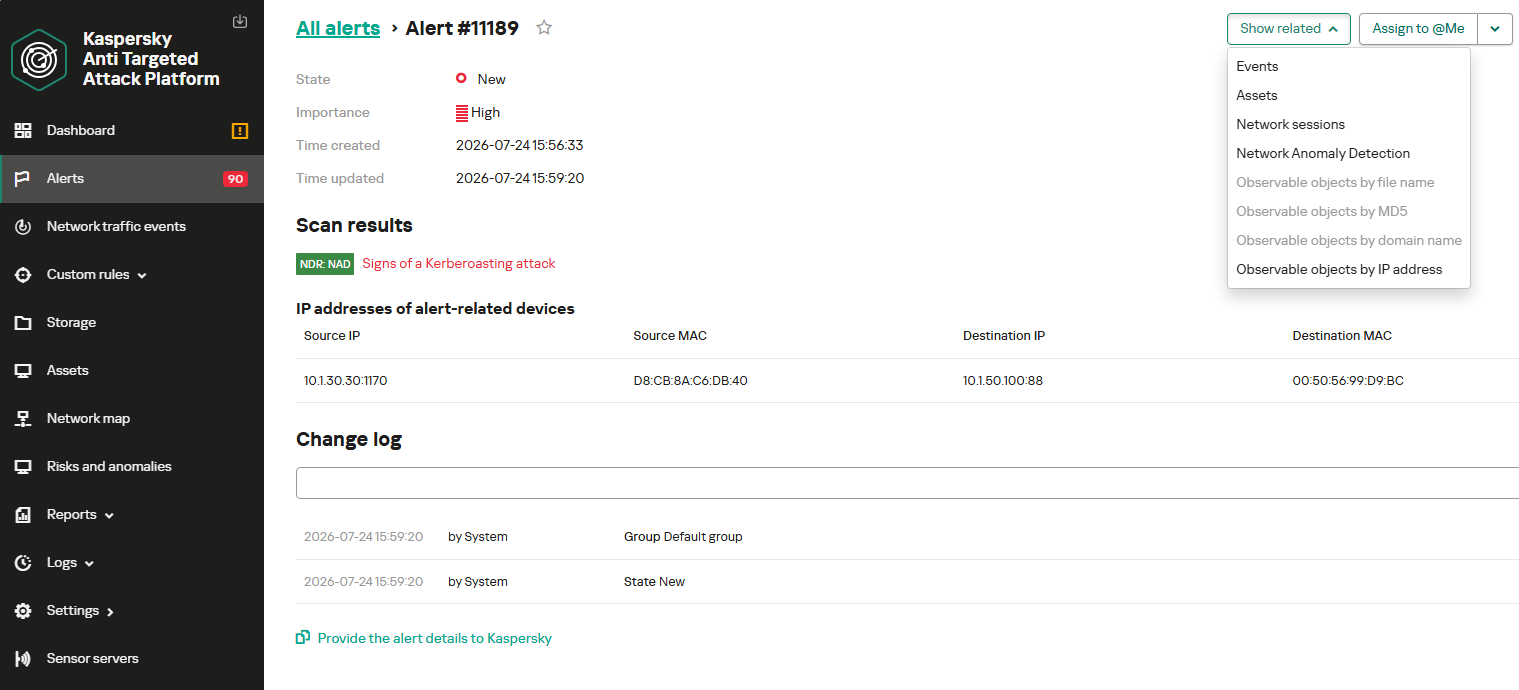
Tarjeta de alerta de la regla de la tecnología NAD
A continuación, es posible acceder al evento vinculado a la alerta, donde se presentan una descripción detallada de la anomalía y enlaces a los hosts afectados.
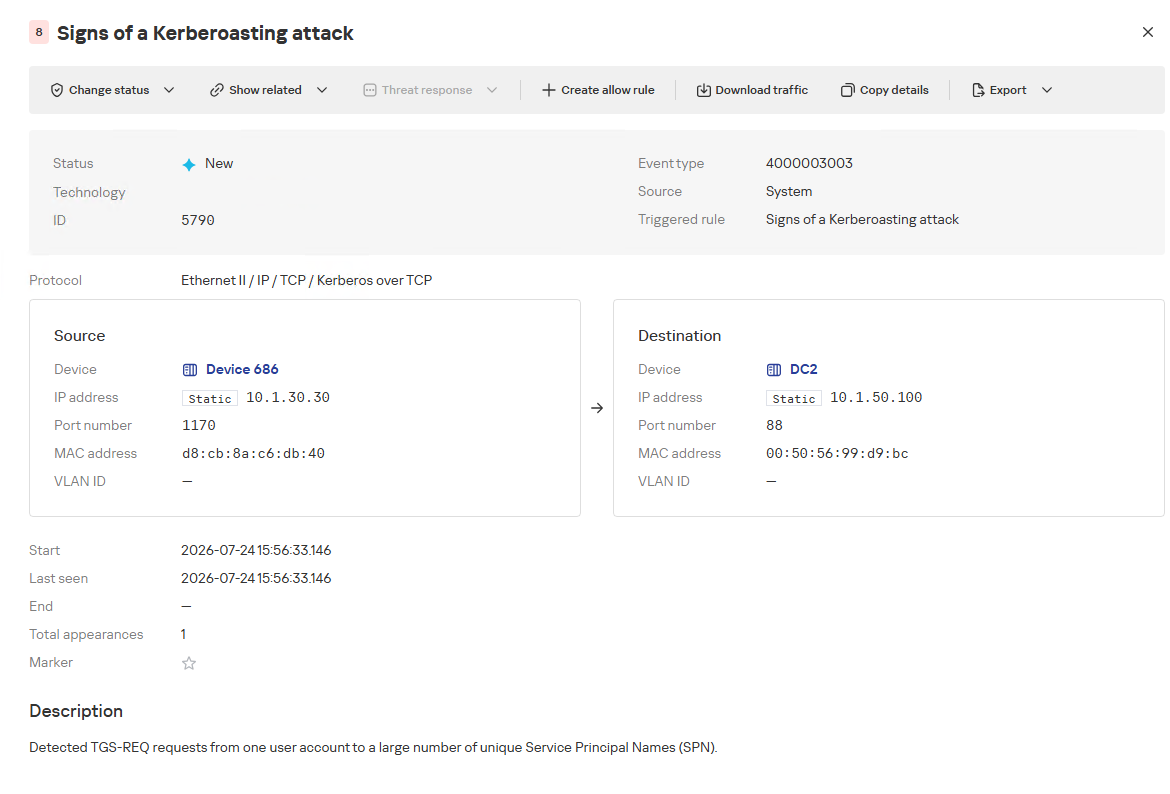
Evento de activación de la regla de la tecnología NAD
Si es necesario, el analista puede ver y exportar las sesiones de red relacionadas con la activación de la regla. Es posible abrirlas desde la alerta o desde el propio evento, mediante el menú desplegable “Mostrar relaciones”.
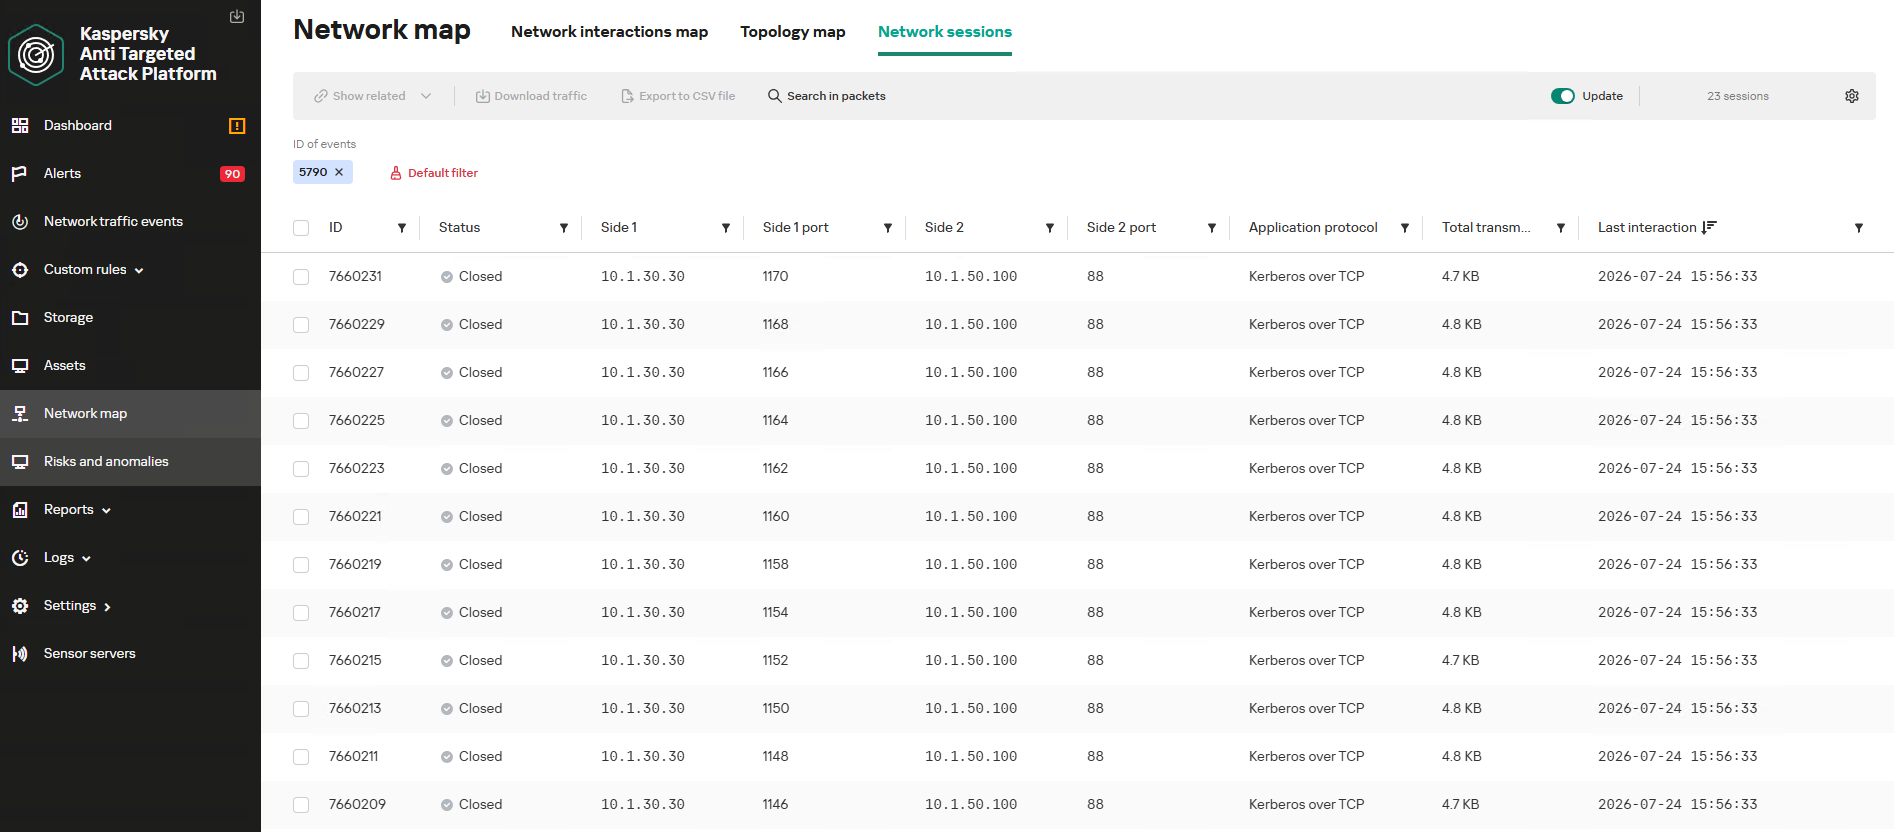
Sesiones de red que provocaron la activación de la regla
En una sesión específica, es posible obtener información estándar sobre las partes de la interacción, el volumen de datos enviados y recibidos, etc. En la pestaña “Atributos”, el analista puede consultar los eventos registrados en la sesión.
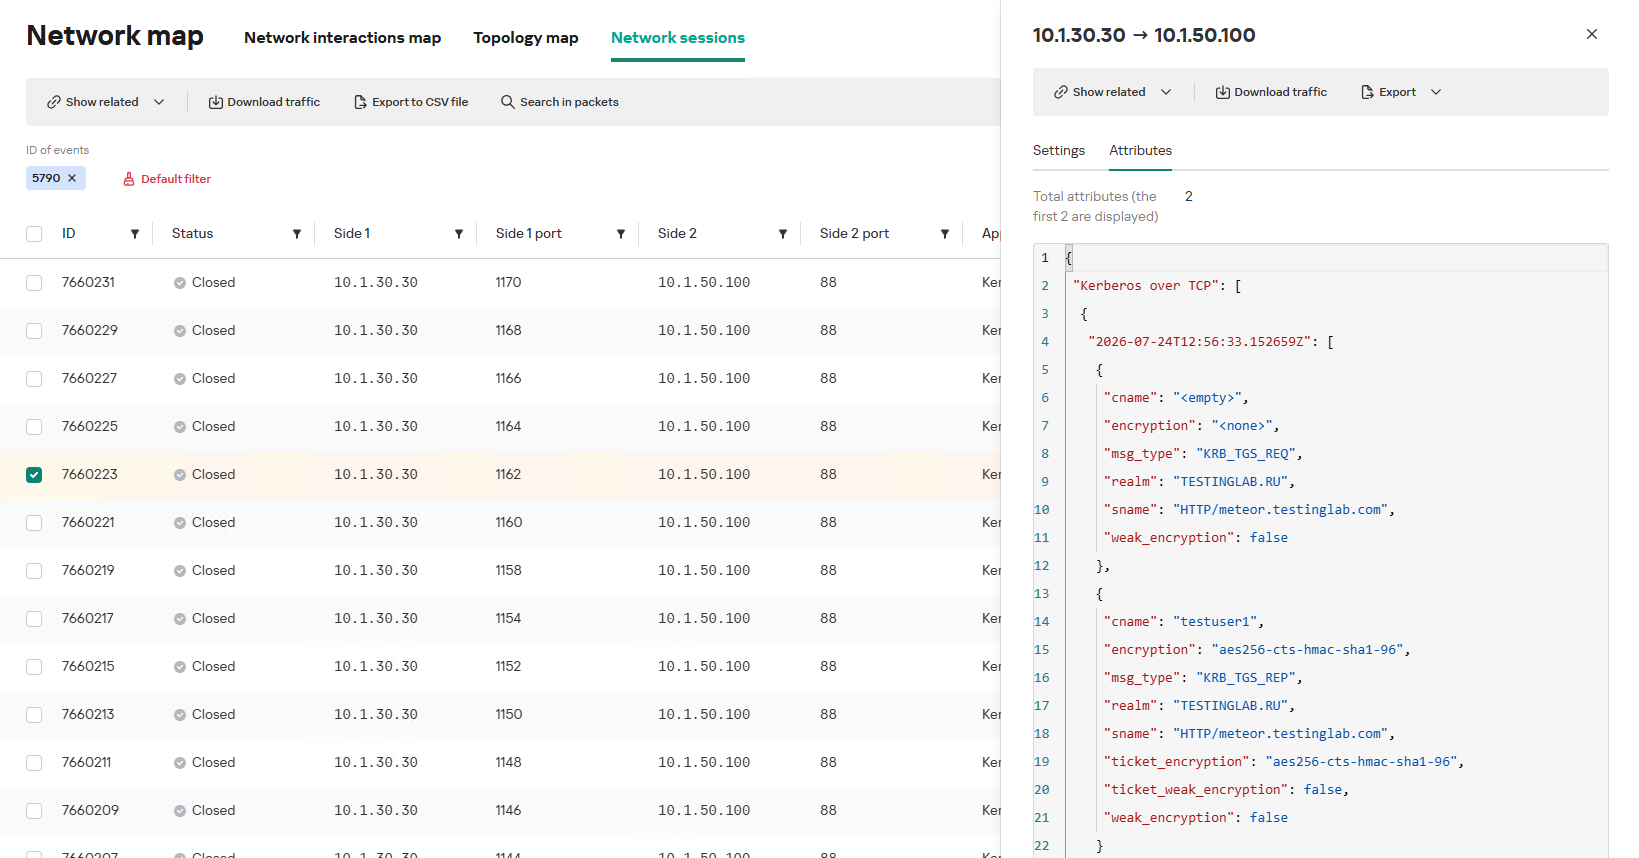
Atributos de la sesión de red
Detección de tunelización de DNS en KATA
Cómo funciona un túnel de DNS
La tunelización de DNS es una técnica para transmitir datos o controlar malware a través de firewalls, que codifica información en las solicitudes y respuestas del protocolo DNS. En lugar de la resolución de nombres habitual, el host infectado envía datos en subdominios y recibe las respuestas mediante registros DNS. Este canal puede usarse para comunicación C2, evasión de restricciones de red o exfiltración de datos.
Por ejemplo, una de las formas de implementar la tunelización de DNS es el uso de registros TXT. En este caso, el cliente genera solicitudes DNS de registros TXT para nombres de dominio en los que la parte derecha del nombre de dominio (los dominios de primer y segundo nivel) es estática, y la parte izquierda (el dominio de nivel inferior) se utiliza para transmitir datos codificados o cifrados del cliente al servidor. La estructura del nombre de dominio, en este caso, será la siguiente: por ejemplo, ZFcABQAIBA[.]testlab[.]local, donde testlab[.]local es la parte derecha estática del dominio, y ZFcABQAIBA es la parte izquierda variable, en la que se transmiten los datos del cliente.
En respuesta a estas solicitudes, el servidor envía comandos o mensajes en el campo de datos de la respuesta TXT. Debido a la estabilidad de la parte derecha del nombre de dominio, todas las solicitudes del cliente llegan siempre al mismo servidor C2, incluso si cambian los servidores DNS a los que se envían.
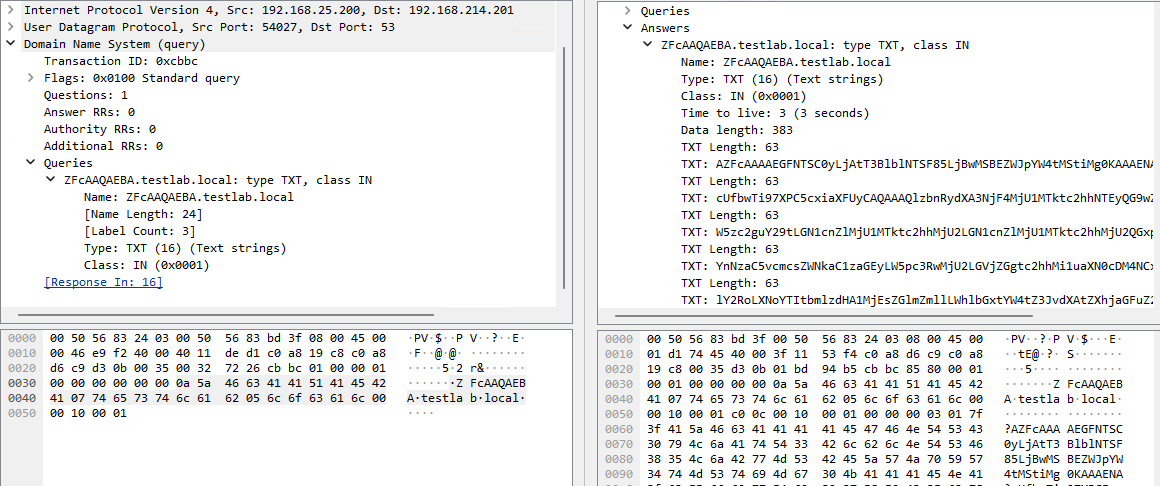
Solicitud DNS (a la izquierda) y su respuesta (a la derecha) en la tunelización de DNS mediante registros TXT
Identificar este tipo de actividad maliciosa en el tráfico DNS sin falsos positivos resulta bastante difícil. El DNS está permitido en casi todas las redes corporativas, los nombres de dominio largos pueden encontrarse tanto en la red interna como en la externa, y los registros TXT pueden usarse con fines técnicos legítimos.
La sospecha se forma a partir de un conjunto de indicios: numerosos subdominios largos y de apariencia aleatoria de un mismo dominio de nivel superior, alta frecuencia de solicitudes, gran número de nombres únicos, tipos de registro inusuales y gran volumen de datos en la sesión DNS.
Tras analizar el tráfico DNS para la detección, identificamos tres campos de interés:
- nombre DNS solicitado;
- tipo de registro DNS;
- campo de datos TXT de la respuesta.
En la figura anterior se puede ver que todos los datos mencionados están presentes en la respuesta DNS. En condiciones reales, este tipo de túnel transmite un volumen de datos mucho mayor que el tráfico DNS habitual.
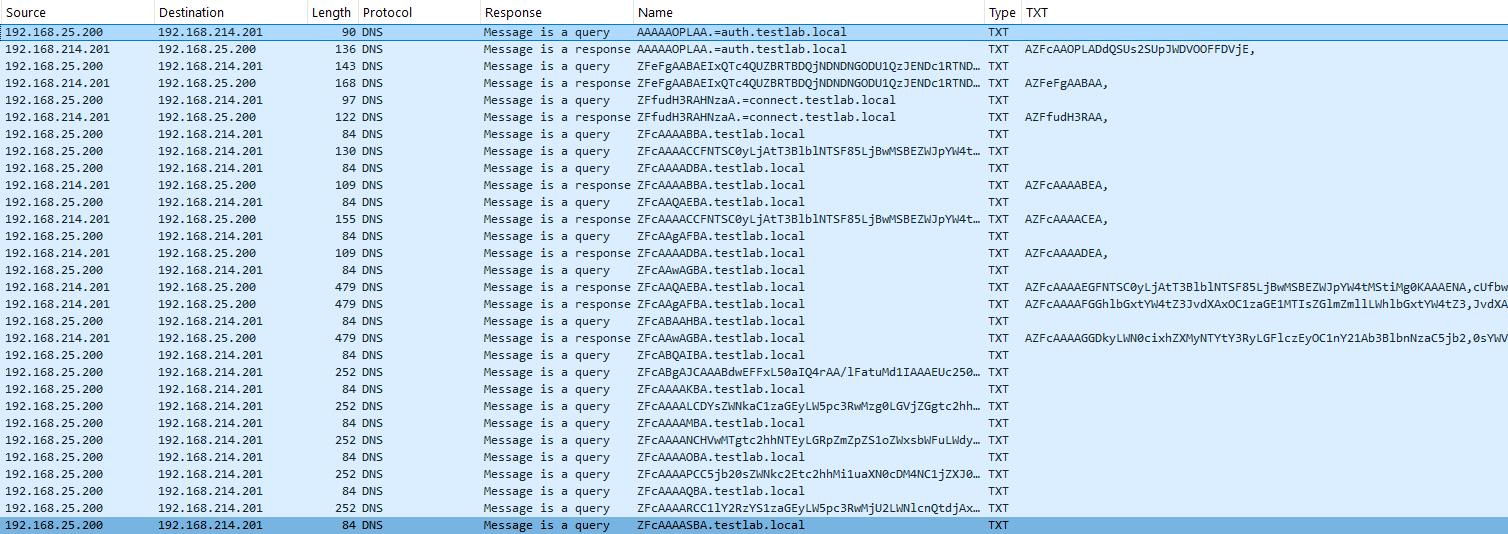
Intercambio de datos en un túnel de DNS
Así, en el caso del uso de la tunelización de DNS, la anomalía de red consiste en la situación en la que un host, origen de las solicitudes, al enviar datos en la parte izquierda variable de los nombres de dominio con la parte derecha estática (rrname), recibe en las respuestas del servidor DNS registros TXT (rtype) con datos variados (rdata). En este caso, el volumen total de datos transmitidos en la parte izquierda del nombre de dominio solicitado y en los datos TXT de la respuesta (rdata + rrname) debe ser mayor que el umbral definido.
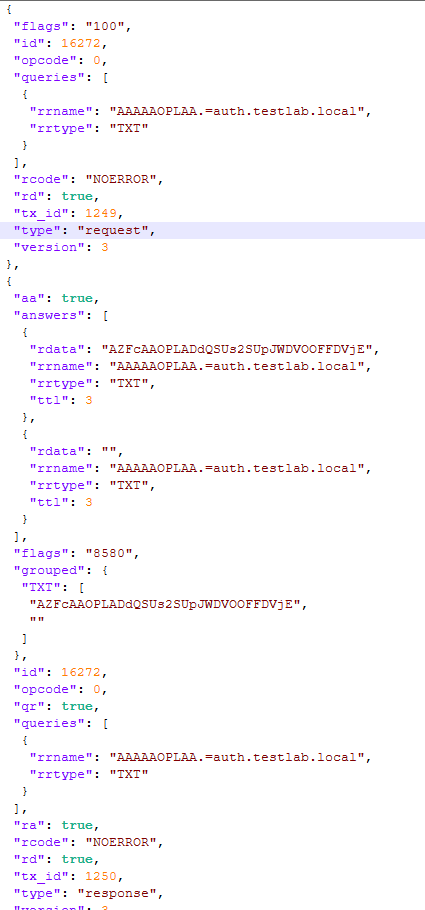
Eventos de solicitud y respuesta en los atributos de la sesión DNS
Al detectar la tunelización de DNS, es importante considerar las siguientes particularidades:
- el túnel no se limita a una única sesión DNS: los datos pueden transmitirse en varias sesiones con el servidor DNS, o cada solicitud puede transmitirse en una sesión independiente;
- una solicitud DNS del cliente puede contener más de un nombre solicitado;
- una respuesta DNS puede contener varios registros TXT, además de un gran número de otros tipos de registro, no solo TXT;
- es necesario excluir el tráfico entre servidores DNS, ya que duplica las solicitudes de los clientes y puede generar falsos positivos;
- a pesar de que los factores antes descritos (parte izquierda del dominio mucho más grande o que cambia con frecuencia, con la parte derecha estática; cadena grande en el registro TXT) son algunos de los indicios de tunelización de DNS, también pueden presentarse en tráfico legítimo.
Estas dificultades generan la posibilidad de falsos positivos en la detección de la tunelización de DNS, en especial mediante IDS. Es casi imposible crear una regla de IDS precisa para este tipo de actividad. Salvo raras excepciones, las herramientas de tunelización de DNS tienen marcadores estáticos que pueden usarse en la detección por firmas. Sin embargo, cuando estos marcadores no existen, este método no puede garantizar una alta precisión de detección sin generar numerosos falsos positivos. En estos casos, es necesario aplicar un enfoque integral que combine distintos indicios para mejorar la calidad de la detección.
Lógica de detección de la tunelización de DNS
Para agregar una regla de detección de la anomalía descrita, es posible usar la plantilla lista “Tunelización de DNS mediante registros TXT” en la interfaz de creación de nueva regla. En la pestaña “Consulta SQL” se mostrará la lista de variables utilizadas:
user_DNS_servers: lista de direcciones de los servidores DNS internos en la infraestructura, para el correcto funcionamiento de la regla y la reducción del número de posibles falsos positivos;excl_sip: direcciones IP excluidas de la aplicación de la regla (es posible indicar una única dirección, una máscara de subred o una lista de direcciones y máscaras);traffic_size: valor de umbral para el volumen de datos (en bytes) transmitidos en el túnel.
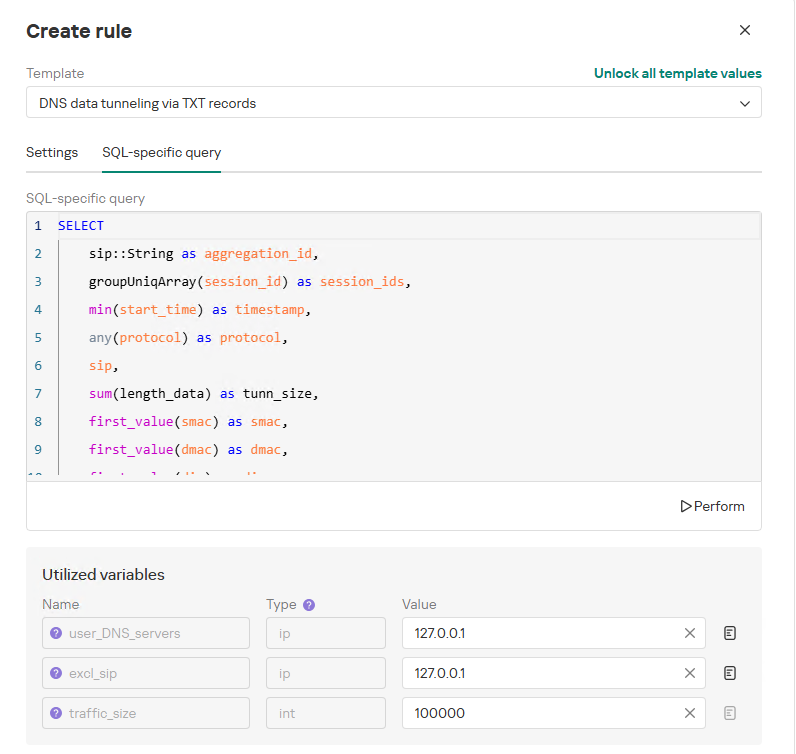
Variables utilizadas en la regla “Tunelización de datos de DNS mediante registros TXT”
La regla de identificación de esta anomalía de red se forma según el siguiente principio:
- De las sesiones de red por el protocolo DNS, en el intervalo de tiempo igual a la profundidad de búsqueda de la regla, se seleccionan las sesiones en las que se registró al menos una respuesta TXT.
En este caso:- la dirección IP desde la que se inició la sesión no debe estar excluida en la variable
excl_sip; - la dirección IP desde la que se inició la sesión no corresponde a los servidores DNS internos listados en la variable
user_DNS_servers; - los nombres DNS solicitados por el cliente no se encuentran entre los excluidos dentro de la regla.
- la dirección IP desde la que se inició la sesión no debe estar excluida en la variable
- Las sesiones DNS correspondientes se dividen en registros individuales, cada uno correspondiente a una solicitud o respuesta específica. De estos registros, se seleccionan solo las respuestas DNS que contienen datos TXT.
- De las respuestas DNS se extraen los nombres DNS y los datos TXT correspondientes a esos nombres. Se conservan solo los valores únicos.
- Todos los registros se agrupan por la dirección IP de origen de las sesiones. Se agregan todos los nombres DNS y datos TXT únicos.
- Se genera una alerta si, para una misma dirección IP, dentro de la ventana de profundidad de búsqueda, el volumen de bytes recopilados en nombres DNS y datos TXT únicos supera el umbral definido (parámetro
traffic_size). - Durante el período igual al tiempo de resolución de repetición del evento, todas las alertas posteriores relacionadas con la misma dirección IP del cliente se combinarán en la primera alerta. Esto evita la creación de nuevos eventos, aumentando en su lugar el contador de agregación de la alerta (indicador “Total de apariciones”).
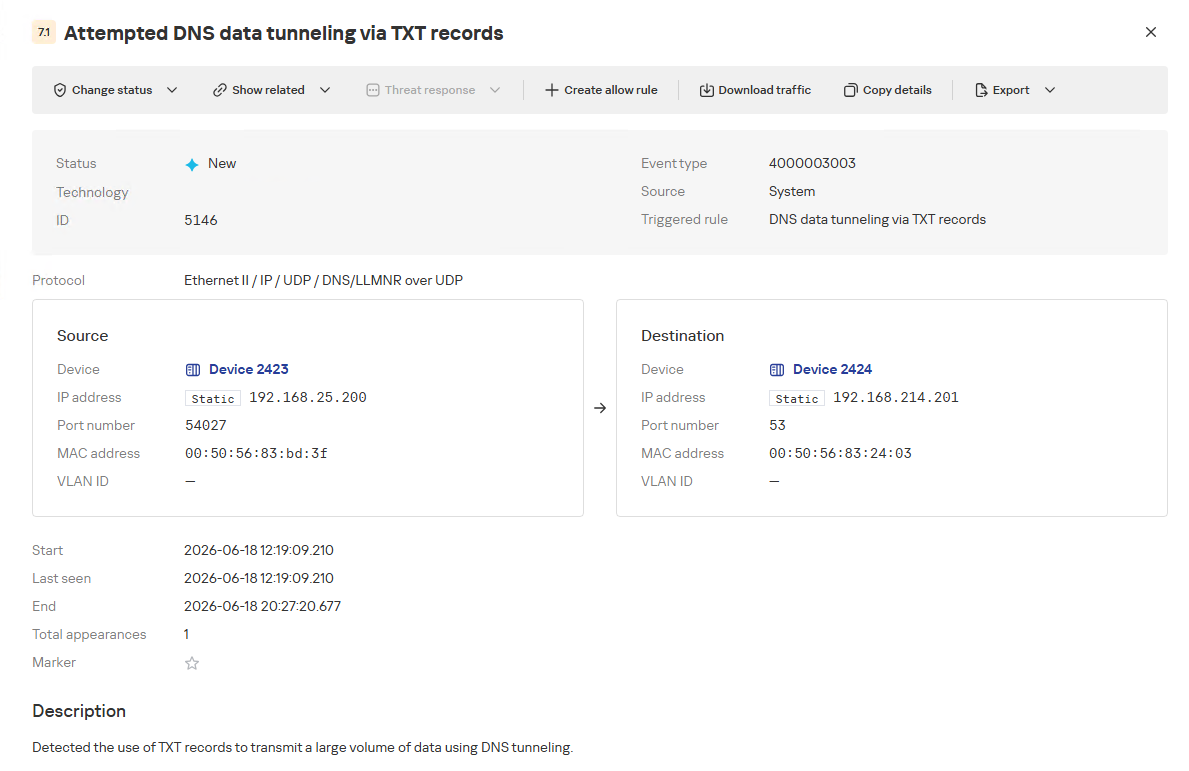
Evento de activación de la regla “Tunelización de datos de DNS mediante registros TXT”
El principal valor de la tecnología NAD en este escenario es la reducción de ruido mediante la disminución de falsos positivos y la aceleración de la investigación. Un túnel de DNS rara vez se presenta como una única solicitud maliciosa evidente. Deja un rastro de comportamiento: repetición, longitud, estructura de los nombres, tipos de registro inusuales, numerosos subdominios con una “base” fija y desviación respecto al patrón del host específico. KATA reúne estos indicios en una sola alerta y presenta al analista una hipótesis de ataque verificable, en lugar de un conjunto de eventos DNS aislados.
Reglas listas para la detección de anomalías de red en KATA
Los usuarios de KATA deben tener en cuenta que, de forma predeterminada, las reglas de detección de anomalías de red (NAD) no están activadas en el producto. Las reglas deben agregarse de forma manual, tal como se describió en las secciones anteriores. Esto se debe a que la mayoría de las reglas requiere que el analista configure las variables a mano, lo que permite adaptarlas con mayor flexibilidad a la infraestructura de red específica.
El analista puede crear nuevas reglas de tres formas.
- Agregar una regla a partir de una plantilla lista y modificar las variables personalizadas. En este caso, la regla se considerará del sistema.
- Agregar una regla a partir de una plantilla lista y modificar su consulta SQL (para ello, será necesario activar la opción “Desbloquear todos los valores de la plantilla”), implementando su propia regla a partir de la plantilla. En este caso, la regla deja de ser del sistema y pasa a ser personalizada.
- Crear una regla personalizada desde cero, para lo cual será necesario conocer los fundamentos del lenguaje de consultas del SGBD ClickHouse y consultar las instrucciones.
En el momento de la publicación, el producto incluye 59 plantillas de reglas de detección de anomalías de red listas para usar (las actualizaciones del producto pueden incluir nuevas plantillas). El producto puede tener hasta 200 reglas activas de forma simultánea.
Las reglas listas se dividen en 6 categorías:
- Large Data Transfers: monitoreo de sesiones de red mucho más grandes de lo normal en distintos protocolos, ya sea en horario habitual, nocturno o durante los fines de semana;
- Suspicious Connections: identificación de conexiones que pueden indicar actividad peligrosa, TI oculta (shadow IT), intentos de evasión de herramientas de detección de ataques, entre otros;
- Domain Attacks: detección de ataques clásicos a la infraestructura de red del dominio mediante herramientas de hacking;
- Reconnaissance Activity: actividad sospechosa en sesiones de red mediante protocolos de dominio (Kerberos, DCE/RPC, LDAP, DNS), similar al reconocimiento dentro del dominio;
- Connections to Suspicious Resources: detección de acciones que infringen las políticas de seguridad de la información, posible exfiltración de datos fuera del perímetro y acceso no autorizado a internet desde segmentos protegidos de la red;
- C2 Communication: detección de sesiones de red características de un posible canal de comunicación o túnel con un servidor C2.
La siguiente tabla presenta la lista de plantillas de reglas de identificación de anomalías de red en KATA.
| Categoría de la regla | Nombre de la regla | Protocolos utilizados |
| Large Data Transfers | Tunelización de datos en el tráfico DNS | DNS |
| Sesiones ICMP/TCP/UDP/RDP/SSH/LDAP con gran volumen de tráfico (6 reglas) | ICMP/TCP/UDP/RDP/SSH/LDAP (según la regla seleccionada) | |
| Sesiones ICMP/TCP/UDP/RDP/SSH/LDAP con gran volumen de tráfico en horario nocturno (6 reglas) | ICMP/TCP/UDP/RDP/SSH/LDAP (según la regla seleccionada) | |
| Sesiones ICMP/TCP/UDP/RDP/SSH/LDAP con gran volumen de tráfico en fines de semana (6 reglas) |
ICMP/TCP/UDP/RDP/SSH/LDAP (según la regla seleccionada) | |
| Suspicious Connections | Solicitudes a servidores DNS desconocidos | DNS |
| Uso de rutas no autorizadas | TCP, UDP | |
| Uso de puertos sospechosos para conexiones con direcciones externas | TCP, UDP | |
| Uso de protocolos atípicos para conexiones | TCP, UDP, HTTP, HTTPS, DNS, SMTP | |
| Incoherencias con la configuración del firewall | TCP, UDP | |
| Uso de puertos no autorizados para sesiones RDP/SSH (2 reglas) | RDP/SSH (según la regla seleccionada) | |
| Interacciones con direcciones IP externas mediante el protocolo RDP/SSH (2 reglas) | RDP/SSH (según la regla seleccionada) | |
| Sesiones RDP sospechosas con controladores de dominio | RDP | |
| Conexión con servidor desconocido mediante los puertos de Kaspersky Security Center | TCP, UDP | |
| Domain Attacks | Indicios de ataque DCSync | DCE/RPC |
| Indicios de ataque DCShadow | DCE/RPC | |
| Indicios de spoofing de DHCP | DHCP | |
| Solicitudes DNS a dominios trampa | DNS | |
| Indicios de ataque Kerberoasting | Kerberos | |
| Indicios de ataque AS-REP Roasting | Kerberos | |
| Indicios de intento de descubrimiento de contraseña por SSH | SSH | |
| Indicios de uso de la herramienta SOAPHound | LDAP | |
| Recopilación de gran volumen de datos sobre objetos de Active Directory mediante solicitudes LDAP | LDAP | |
| Reconnaissance Activity | Obtención de información sobre tarea en el Programador de tareas | DCE/RPC |
| Obtención de la lista de usuarios Kerberos | Kerberos | |
| Solicitudes LDAP al atributo de delegación de derechos | LDAP | |
| Solicitudes LDAP al atributo de obtención de contraseñas de administradores | LDAP | |
| Indicios de escaneo horizontal interno de puertos | TCP, UDP | |
| Indicios de escaneo vertical interno de puertos | TCP, UDP | |
| Solicitudes de replicación de datos de zona DNS no originadas en servidores DNS | DNS | |
| Solicitudes de replicación de datos de zona DNS completadas con éxito, no originadas en servidores DNS | DNS | |
| Solicitud LDAP por el atributo crítico de credenciales desprotegidas | LDAP | |
| Análisis de cuentas de dominio mediante solicitudes LDAP | LDAP | |
| Superación del valor de umbral de atributos críticos solicitados en solicitudes LDAP | LDAP | |
| Solicitudes de búsqueda LDAP con gran cantidad de atributos críticos | LDAP | |
| Connections to Suspicious Resources | Accesos a nombres de dominio no autorizados | DNS |
| Envío de grandes volúmenes de datos a almacenamientos en la nube | TCP, UDP, DNS | |
| Conexiones con almacenamientos en la nube o servicios de intercambio de archivos | TCP, DNS | |
| Conexiones con repositorios públicos | TCP, DNS | |
| Conexiones con recursos de programas de tunelización de tráfico | TCP, DNS | |
| C2 Communication | Posibles accesos a dominios DGA | DNS |
| Tunelización de datos de DNS mediante registros TXT | DNS | |
| Numerosas conexiones bloqueadas con direcciones externas | TCP, UDP |
Conclusión
Los ejemplos de los ataques lanzados mediante Kerberoasting y tunelización de DNS muestran con claridad por qué la defensa moderna no puede limitarse a buscar solo firmas conocidas e indicadores de compromiso. Ambos ataques utilizan protocolos que funcionan a diario en la red corporativa. A nivel de eventos individuales, pueden parecer actividad legítima, pero en el contexto del comportamiento se convierten en indicios de compromiso.
La tecnología NAD cubre justo esa brecha. Ayuda a identificar no solo las alertas por firmas en el tráfico Kerberos o DNS, sino también la desviación respecto al modelo habitual: quién inició la actividad, con qué frecuencia se repitió, qué servicios o dominios se vieron afectados y por qué esto es relevante para la infraestructura específica.
Como resultado, el analista obtiene un punto de entrada claro para la investigación. Esto resulta muy valioso para detectar indicios de la actividad de grupos APT, que actúan de forma discreta e intentan camuflarse como actividad legítima. La importancia de esta capacidad solo aumentará con el tiempo: cuanto más rápido se desarrolle un ataque, más crucial será identificar la actividad sospechosa en las etapas iniciales, antes de que derive en el compromiso de servicios críticos o la fuga de datos.

Detección de anomalías de red en KATA