

El uso de los servicios en la nube implica una relación de confianza: el usuario le confía al proveedor de nube la configuración y el mantenimiento de los servicios de TI, incluido el almacenamiento de datos. Por su parte, el proveedor asume el compromiso de mantener en funcionamiento los servicios alojados en su infraestructura, y garantiza que los datos se almacenarán bajo estricta confidencialidad.
Para evaluar la seguridad de sus plataformas, los proveedores eligen distintas estrategias: algunos lanzan programas de bug bounty, otros establecen auditorías internas periódicas y otros contratan equipos de investigación externos. Sin embargo, las pruebas de penetración (pentests) de infraestructuras en la nube todavía carecen de una metodología unificada: no existe un estándar único y el éxito de la evaluación depende de la experiencia y el nivel de cada equipo.
La mayoría de los pentests en este ámbito se centran en el perímetro externo: se prueban el panel de administración, las interfaces del cliente, las API y el perímetro de red básico. Es una capa importante, pero aún superficial.
En este artículo introductorio, compartimos nuestro enfoque de las pruebas de penetración de entornos en la nube, que hemos construido a lo largo de varios años en decenas de proyectos. No pretendemos cubrir de forma exhaustiva todos los escenarios posibles, sino mostrar la lógica de razonamiento durante los pentests y destacar aspectos menos obvios que no siempre saltan a la vista.
Puntos clave
- La infraestructura en la nube es más compleja que una aplicación web clásica. Se la puede representar como un hotel con tres zonas: el sitio de reservas (External, el perímetro externo), las habitaciones de los huéspedes (Overlay, la capa lógica) y el área del personal (Underlay, la capa de infraestructura o base). Un servicio en la nube está bien protegido si no es posible vulnerar los límites de confianza entre estos perímetros.
- El valor de un pentest en la nube no se mide por la cantidad de vulnerabilidades encontradas ni por el simple hecho de ejecutar código. La ejecución remota de comandos en un contenedor aislado del cliente es solo el comienzo del pentest, no el final. El objetivo principal es demostrar que un atacante puede superar los límites de confianza.
- La investigación debe responder a cinco preguntas críticas: ¿puede un atacante leer, modificar o eliminar datos de otros clientes?; ¿es posible interceptar la cuenta de servicio IAM del proveedor?; ¿puede el compromiso del entorno de ejecución permitirle propagar el ataque a otros recursos y servicios?; ¿es posible afectar los recursos internos del proveedor desde segmentos con un nivel de confianza bajo?; ¿es posible escapar del entorno virtual?
- Un resultado negativo también es un resultado. Si el pentester no logró pasar del entorno del cliente (tenant plane) al entorno interno del proveedor (provider overlay), se trata de una conclusión valiosa. Muestra qué límites de protección funcionan en la práctica y cuáles se sostienen solo en supuestos y requieren mecanismos de control adicionales.
Términos principales
A continuación, explicamos algunos términos específicos que se usan con frecuencia en las infraestructuras en la nube.
Mostrar definiciones
Tenant (del inglés tenant, inquilino o arrendatario): unidad lógicamente aislada dentro de una plataforma en la nube. Puede ser, por ejemplo, un usuario (en particular, una organización), un proyecto o una cuenta concreta en la nube, u otra unidad de aislamiento administrativo y de recursos.
Entorno del cliente (tenant plane): servicios de TI y datos que el cliente administra con normalidad, como una máquina virtual, clústeres de Kubernetes, una base de datos, almacenamientos de objetos y aplicaciones administradas.
Panel de administración (management console): interfaz web gráfica y punto de entrada del cliente en el nivel External.
Entorno de ejecución del servicio (service runtime): entorno real en el que funciona el producto en la nube del proveedor, ya sea un proceso, un contenedor, un pod, una máquina virtual o una microVM.
Plano de administración del servicio (service management plane): componentes internos del proveedor que crean, actualizan, reinician, respaldan y eliminan el entorno de ejecución del servicio (service runtime).
Cuenta de servicio IAM (service identity): identificador digital especial para programas, robots, servicios en la nube o servidores que les permite acceder de forma automática y segura a los recursos en la nube necesarios, sin intervención humana.
Contexto (en seguridad en la nube): conjunto de atributos y credenciales que determinan los permisos actuales y el entorno de ejecución de un sujeto en el sistema. Incluye el identificador utilizado (por ejemplo, el token de una cuenta de servicio, un certificado o una clave), el nivel de privilegios (roles, políticas IAM) y el entorno técnico (contenedor, máquina virtual, segmento de red) desde el que se inicia la solicitud.
Zona inicial (initial zone): contexto en el que se encuentra el investigador justo después de la primera transición exitosa, es decir, el entorno de ejecución concreto (runtime), la cuenta de servicio IAM (service identity), el espacio de nombres (namespace), las rutas de red y el conjunto de servicios disponibles.
Entorno interno del proveedor (provider overlay): entorno interno del proveedor, oculto para el cliente y accesible desde la zona inicial (initial zone), que abarca segmentos de red, zonas DNS, API de servicio y componentes de administración.
Plano de control (control plane): componentes de la plataforma que toman decisiones globales de administración y modifican su estado, es decir, asignan recursos, otorgan permisos, configuran la red y coordinan el estado.
Plano de datos (data plane): componentes que transportan o procesan datos de los usuarios y tráfico de aplicaciones. Existen componentes (o sistemas) que se ubican en la intersección de distintos niveles arquitectónicos, por lo que no pueden asignarse automáticamente al plano de datos o al plano de control. Por ejemplo, los sistemas de registro de eventos (logging), de respaldo y de facturación. Cambian de función según la tarea concreta que el componente realiza en ese momento y según cómo su funcionamiento afecta al tráfico de los usuarios.
Celda (cell): fragmento delimitado de la plataforma dentro del cual se comparten componentes de cómputo, disco, red o administración (suele estar vinculado a una región, una zona de disponibilidad, un tipo de servicio o un grupo de clientes).
Pods (del inglés pod, vaina): las unidades de cómputo más pequeñas de Kubernetes. Constan de uno o varios contenedores desplegados en un mismo host que comparten recursos.
Impacto entre tenants (cross-tenant impact): impacto confirmado desde el contexto de un tenant sobre los recursos de otro, sin una relación de confianza prevista por la arquitectura.
Impacto a nivel del proveedor (provider-level impact): efecto sobre un componente de administración, de infraestructura o de la cadena de suministro del proveedor que va más allá del recurso original del cliente.
Carga de trabajo del cliente (tenant workload): conjunto de recursos de cómputo, procesos y aplicaciones que el cliente ejecuta y utiliza en su tenant para realizar tareas de negocio. Incluye máquinas virtuales, contenedores (por ejemplo, un pod en Kubernetes), funciones serverless, bases de datos administradas y cualquier otro servicio activo que procese datos del cliente.
Qué debe verificar el pentester
En el marco del proyecto, el pentester debe estudiar no solo el panel de administración, sino también los límites que separan el entorno del cliente de los servicios administrados y de la infraestructura interna del proveedor. Una sola solicitud pasa por numerosos componentes, desde el gateway de API hasta el sistema de almacenamiento. Un error de configuración en cualquiera de ellos cambia el contexto del ataque: el investigador obtiene una cuenta de servicio IAM, acceso a la red interna de la nube o la posibilidad de afectar el tenant de otro cliente.
Por eso, un pentest en la nube no es solo la búsqueda de vulnerabilidades en el panel de administración ni el escaneo secuencial de las subredes de la nube. Ante todo, es la verificación de los límites de confianza, es decir, el control de las transiciones entre zonas con distintos niveles de confianza. La zona de mayor confianza considera que todo lo que proviene de la zona de menor confianza podría ser hostil.
¿Qué hace que un límite sea real? Los mecanismos de control: autenticación y autorización (IAM, RBAC), aislamiento (virtualización, contenedorización, segmentación de red), criptografía (mTLS), procesamiento de datos de entrada, entre otros. Elaboramos un mapa de los posibles límites y verificamos cada uno: si realmente está respaldado por mecanismos de control o si se sostiene en supuestos (arquitectónicos, de infraestructura, de implementación, etc.).
La plataforma en la nube como objeto de investigación
Al comenzar el análisis de seguridad de un sistema tradicional, solemos partir de patrones arquitectónicos básicos. Para las aplicaciones web, se trata de una pila convencional compuesta por un servidor web (Nginx, Apache, etc.), lógica del lado del servidor, almacenamiento de objetos e integraciones con servicios de terceros. Para las soluciones de hardware, es la cadena que va de las interfaces físicas al firmware y a los handlers de protocolos.
Las soluciones en la nube se caracterizan por una gran incertidumbre en la implementación arquitectónica. Los estándares y las arquitecturas de referencia de cómputo en la nube (por ejemplo, NIST SP 800-145 e ISO/IEC 17788) definen los roles de los participantes y las relaciones entre los componentes de la nube, pero no imponen reglas estrictas para implementar la plataforma.
Ante la falta de una normativa técnica única, una base de datos administrada (managed database) que parece idéntica funciona, en un proveedor, en una máquina virtual aislada; en otro, en un espacio de nombres de un clúster de Kubernetes compartido; y en un tercero, en un clúster dedicado del entorno del cliente (tenant cluster). La misma variabilidad se aplica a la elección del software. El proveedor puede utilizar OpenStack, Kubernetes, un plano de control propio o una combinación de ellos; por eso, un nombre de producto conocido no ofrece una visión completa de la estructura interna del sistema.
Esa es la razón por la que un pentest en la nube es más complejo que el análisis de un sistema tradicional: después de vulnerar el límite de confianza del cliente (por ejemplo, al escapar de una microVM al sistema operativo del host), la investigación deja de ser una simple búsqueda del siguiente puerto abierto y se convierte en la reconstrucción de la arquitectura a partir de indicios indirectos. El pentester arma el rompecabezas estudiando los procesos en ejecución, las rutas de red, los certificados, los nombres de los servicios y la configuración de los agentes. A partir de ellos, el investigador determina la función de cada componente y sus límites de confianza.
Para no vincular nuestro enfoque a un proveedor específico, analizaremos la infraestructura en la nube sin referirnos a marcas concretas. Según el escenario arquitectónico, un mismo componente puede implementarse de formas radicalmente distintas. Por ejemplo, una base de datos administrada puede, en el primer caso, funcionar como un servicio administrado independiente, aislado a nivel de máquina virtual (donde los principales riesgos son la seguridad del hipervisor y de la API de administración) y, en el segundo caso, como un contenedor dentro de un clúster de Kubernetes compartido (donde la amenaza se relaciona con el escape del contenedor al host y con la calidad del aislamiento del espacio de nombres).
La analogía del hotel y los tres niveles de la nube
Para sistematizar el pentest ante la falta de un estándar único para construir infraestructuras en la nube, utilizamos una división interna de la nube en tres niveles: External, Overlay y Underlay. Lo más sencillo es imaginar la plataforma en la nube como un gran hotel: tiene un área pública para los huéspedes, áreas de servicio para el personal y pisos técnicos con instalaciones de ingeniería. Esta analogía no abarca todos los detalles, pero muestra bien cómo se distribuyen las zonas de responsabilidad y las transiciones entre ellas.
Capa externa (External): en el hotel, es el sitio de reservaciones, las puertas y la recepción. En este nivel, el pentester interactúa con los componentes de la nube igual que un usuario típico: inicia sesión en su cuenta, accede a la API pública, crea servicios de TI y se conecta a sus endpoints. El trabajo en este nivel es similar a una prueba de penetración externa o a una evaluación de seguridad de aplicaciones. El objetivo principal es obtener acceso inicial desde el exterior al tenant de otro cliente o pasar al nivel Overlay.
En el nivel External se otorga el acceso al tenant con normalidad. En el hotel, es la habitación misma: el huésped dispone de los objetos y del equipo dentro de su habitación, pero su tarjeta no debe abrir las habitaciones vecinas. En la nube, el cliente administra solo sus propios datos, máquinas virtuales, pods, bases de datos, almacenamientos de objetos (S3 buckets) y cuentas dentro de su proyecto. El tenant no es un nivel independiente de la infraestructura, sino lo que el usuario obtiene en el nivel External. Justo aquí terminan sus permisos legítimos y comienza el primer límite de confianza que verifica el pentester.
Capa de servicios del proveedor (Overlay): en el hotel, es la zona “Solo personal autorizado”, con cocinas, lavanderías, sala de control, pasillos de servicio y las llaves maestras. En la infraestructura en la nube, es la capa lógica interna de administración de servicios: los entornos de ejecución de los servicios administrados, los planificadores, los sistemas de respaldo, monitoreo (observability) y facturación, el sistema IAM y las API internas. El cliente utiliza los servicios que se prestan desde esta capa pero no debe tener acceso a ellos, salvo que la arquitectura lo contemple de forma expresa.
Es importante no confundir este término con la red de superposición (overlay) de la ingeniería de redes clásica (una red lógica sobre la red de transporte underlay, por ejemplo, segmentos VXLAN). En nuestra metodología, Overlay tiene un sentido más amplio: la capa lógica interna de ejecución y administración de los servicios en la nube, que puede subdividirse según la nube concreta. En la tabla siguiente, para mayor claridad, se divide en dos subniveles: los entornos de ejecución de los servicios del cliente y los componentes internos del proveedor.
Capa de infraestructura (Underlay): en el hotel, son las instalaciones de ingeniería, el equipo eléctrico y los sistemas de control de acceso físico, que garantizan el funcionamiento del edificio en su conjunto. En la nube, es la capa de hardware: servidores físicos, sistemas operativos de host, hipervisores, red de transporte, sistemas de almacenamiento y administración fuera de banda. Un trabajo descuidado en este nivel puede tener graves consecuencias.
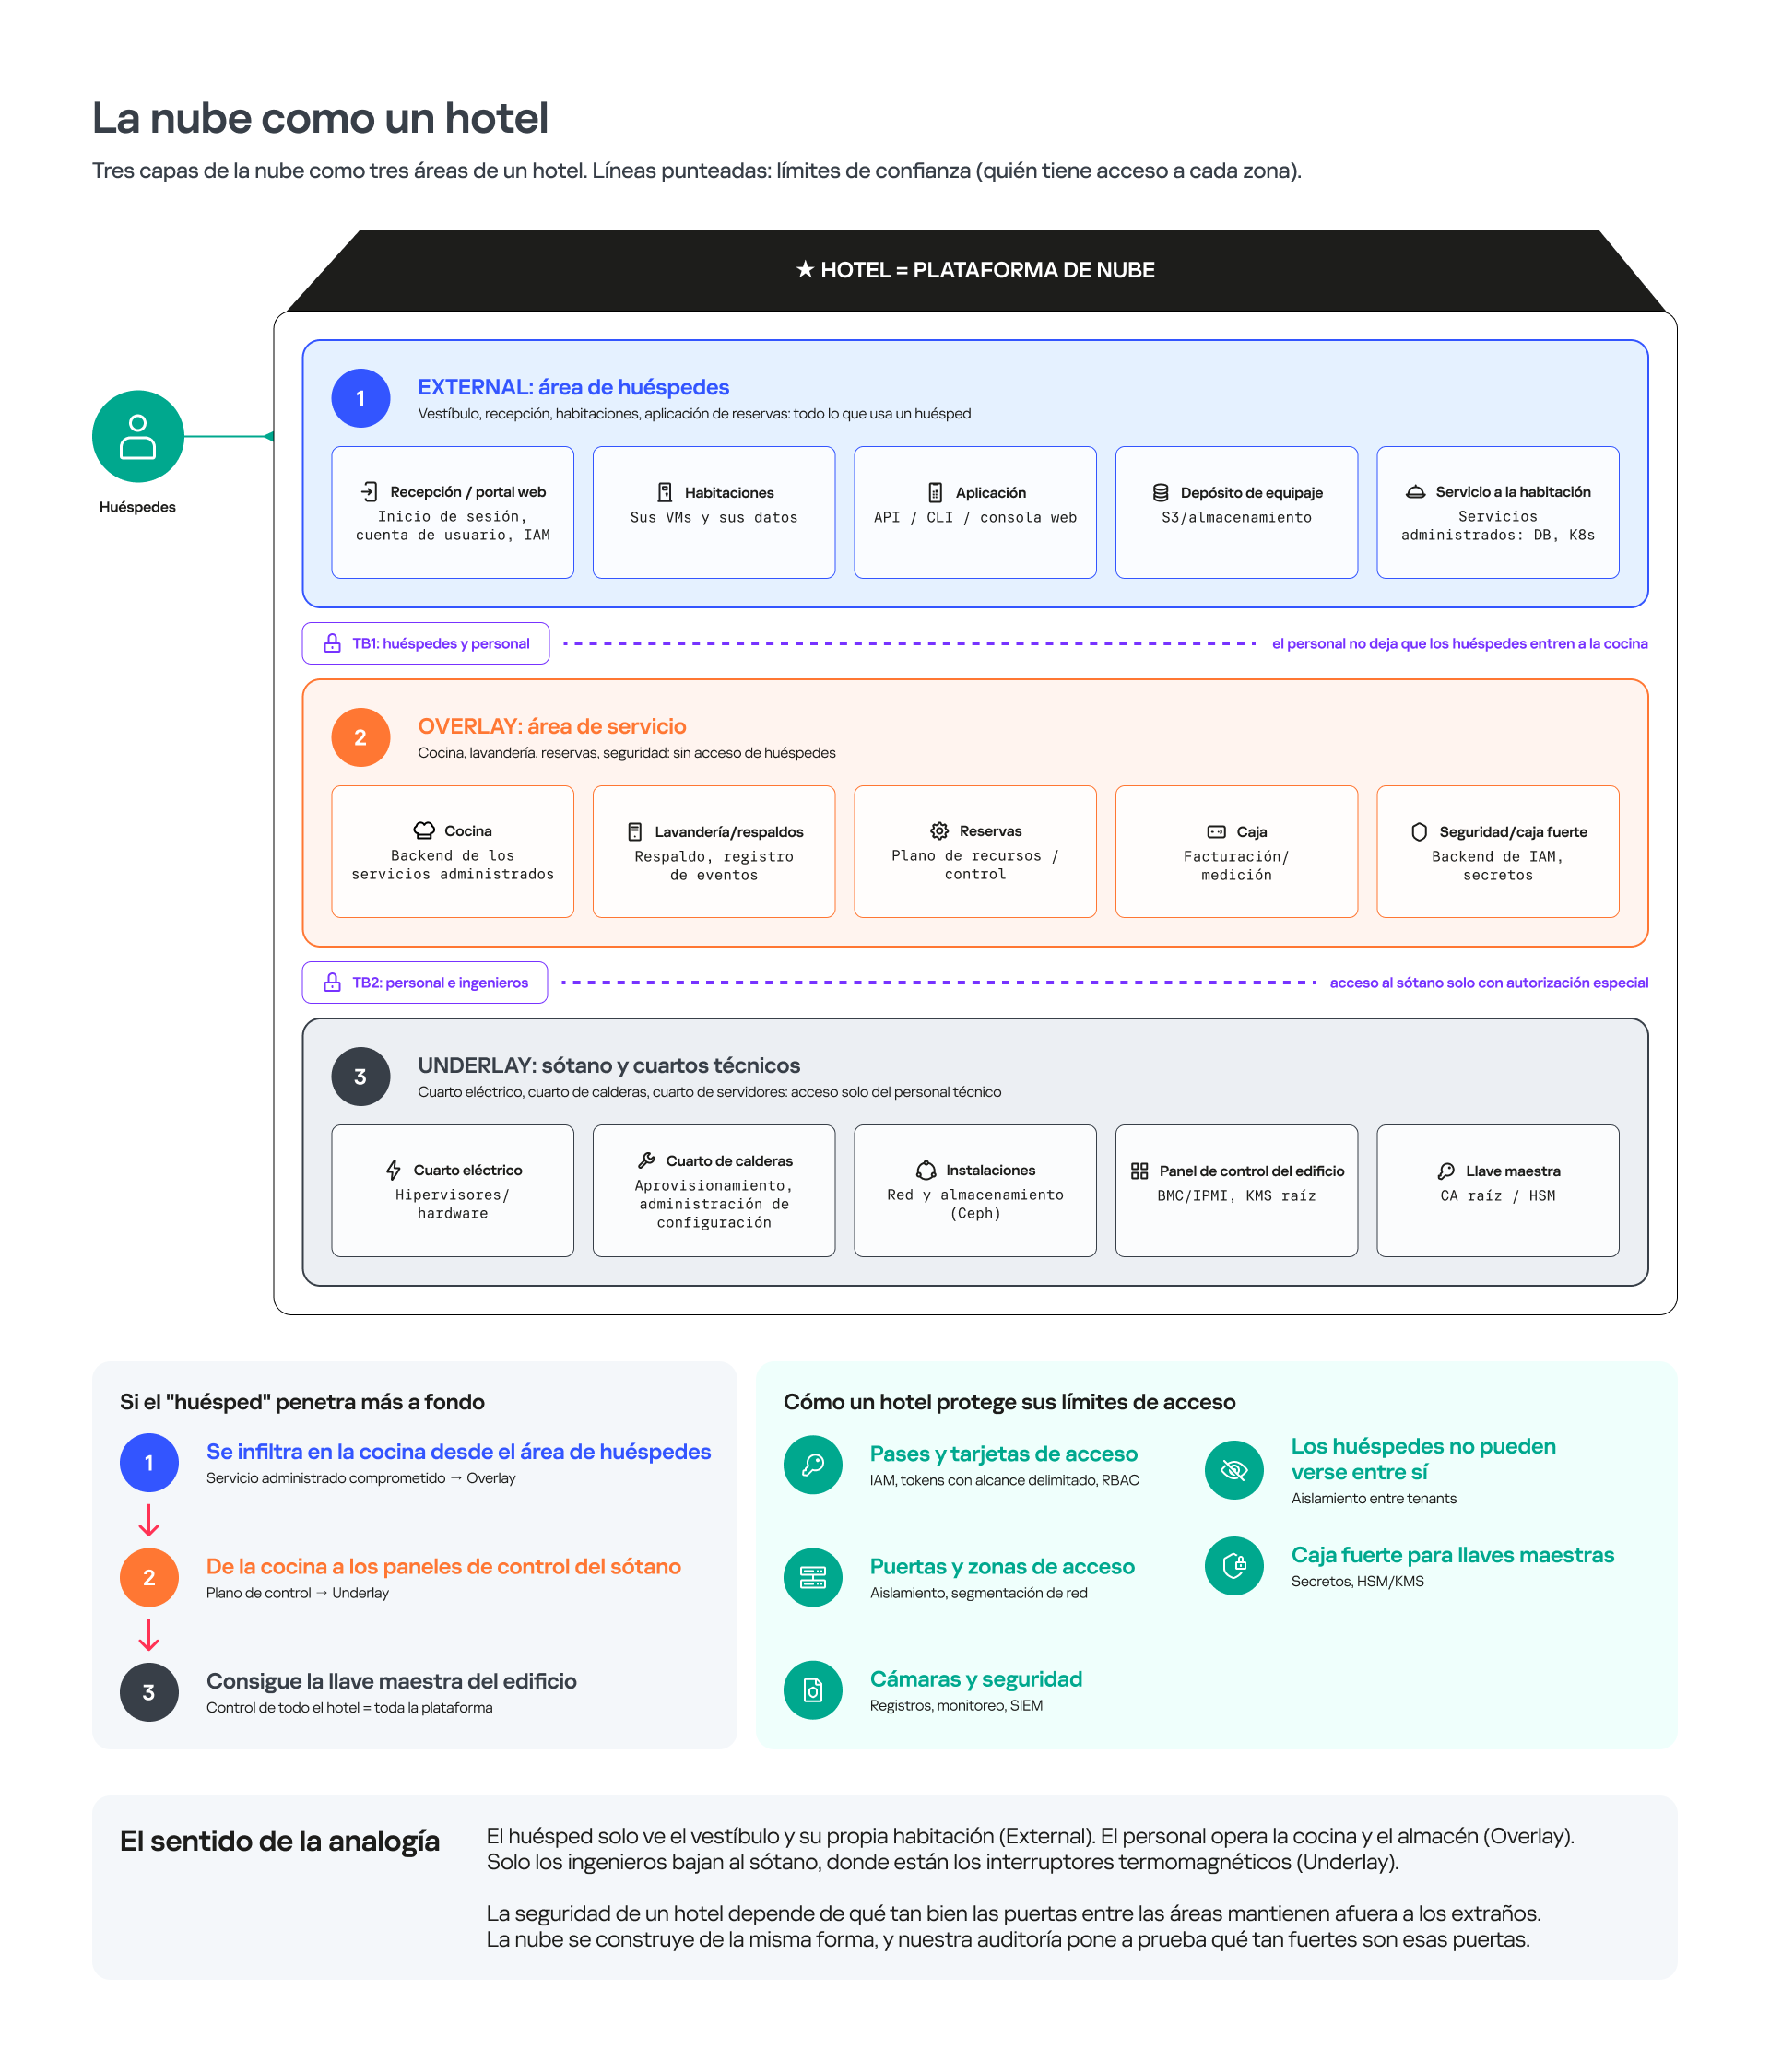
Sin embargo, lo principal en esta analogía no son las habitaciones, sino las puertas entre ellas. Una vulnerabilidad en el sitio de reservas es peligrosa, pero si se encuentra una llave maestra en la habitación, que abre todas las puertas del edificio, es mucho peor. En la nube se aplica la misma regla: la posibilidad de ejecución remota de código (RCE) dentro de un contenedor aislado del cliente (pod) es solo un problema local, pero si se compromete una cuenta de servicio IAM que administra los recursos de una región, toda la plataforma queda afectada.
A continuación, presentamos una tabla con ejemplos de componentes, puntos de entrada del pentester y objetivos de verificación para cada nivel. Dividimos el nivel Overlay en dos subniveles, ya que el entorno de ejecución del servicio del cliente y la infraestructura interna del proveedor tienen límites de confianza y puntos de entrada distintos.
| Nivel | Qué hay dentro | Punto de entrada típico del pentester | Objetivo principal de la verificación |
| External (nivel externo) | Interfaz pública de la nube (API), panel de administración, IAM, endpoints de interacción con los servicios de TI, SDK. | Internet o una cuenta de cliente común. | Obtención de acceso inicial al entorno del cliente (tenant), ejecución de código, compromiso de la cuenta de servicio IAM (service identity). |
| Overlay (servicios de TI) | Entorno de ejecución del servicio (runtime): sistema operativo y sus componentes, agentes de servicio del proveedor y del producto, SGBD. | Consultas SQL del usuario, código ejecutado dentro de tareas, complementos importados o imágenes de sistemas operativos. | Vulnerar el aislamiento del entorno de ejecución del servicio (runtime) y detectar privilegios excesivos de la cuenta de servicio IAM asignada (service identity). |
| Overlay (componentes del proveedor) | Sistema de facturación, respaldos, monitoreo, sistema de control de acceso, API interna de la nube. | Zona inicial (initial zone) confirmada, obtenida en el paso anterior o proporcionada por el proveedor de nube para reducir el tiempo. | Vulnerar los límites entre servicios, vulnerar el aislamiento de los tenants, encontrar formas de interactuar con el plano de control o con los servicios de TI. |
| Underlay (capa de infraestructura) | Sistemas operativos de host, sistemas de virtualización (hipervisores), red de transporte, sistemas de almacenamiento de datos, controladores de administración de hardware (BMC) y otros mecanismos de bajo nivel. | Máquina virtual controlada con acceso a la capa de infraestructura o cuenta de servicio IAM privilegiada (service identity). | Verificar el aislamiento de la virtualización y de las cargas de trabajo vecinas, así como el alcance real del impacto. |
Pero, en la práctica, una plataforma en la nube no siempre se ajusta a esta matriz. El entorno de ejecución del servicio puede ser una máquina virtual independiente, un pod en un clúster compartido o una microVM. El hipervisor pertenece al nivel Underlay, pero su API de administración puede ser accesible desde Overlay. Por eso, el nivel actual (External, Overlay o Underlay) en el que se encuentra el pentester no se determina solo por la dirección IP, sino por la combinación de cuatro características:
- Quién controla el componente de la infraestructura en la nube.
- A quién pertenecen los datos y recursos que atiende.
- Qué cuenta de servicio IAM se utiliza para la interacción.
- Qué tan amplio es el alcance de sus permisos.
Por dónde pasan los límites de confianza
Al analizar la red que sustenta la infraestructura interna de la nube, se puede llegar a la conclusión errada de que existe un solo límite de confianza: entre el cliente y el proveedor. Sin embargo, el acceso del pentester a la red interna del proveedor puede ser apenas el primer paso: dentro de una plataforma real existen muchas zonas con distintos niveles de confianza, y el compromiso de un componente no otorga necesariamente acceso a toda la infraestructura. Por ejemplo, la solicitud de un usuario puede pasar sucesivamente por la interfaz del cliente (panel de administración), luego por el entorno del cliente (base de datos), después por el entorno de ejecución del servicio (la máquina virtual en la que funciona la base de datos), a continuación por el plano de administración del servicio (servicio interno de monitoreo del estado de la base de datos) y por el plano de control de la nube (servicio interno de administración de los recursos de la base de datos), y solo entonces llegar a la capa de infraestructura.
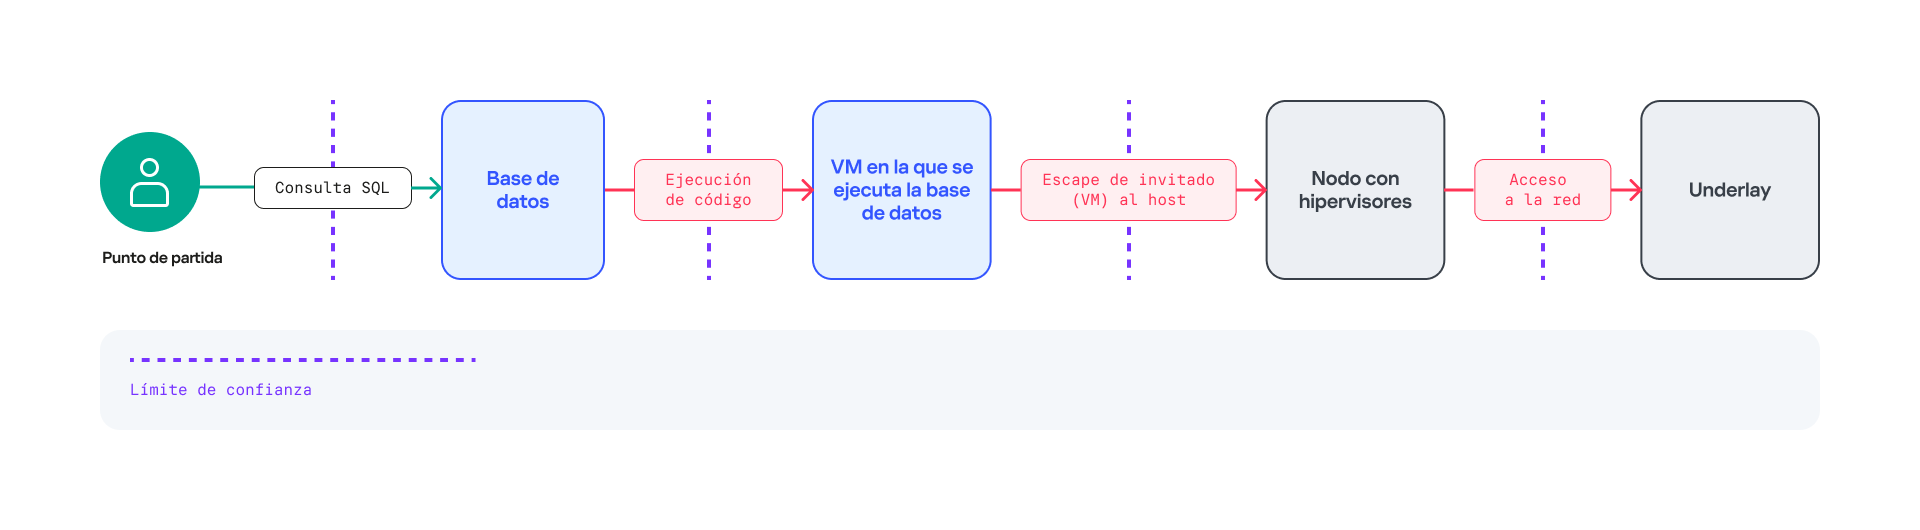
Cada transición cambia la zona de confianza, pero no garantiza el acceso a una nueva subred ni la obtención de privilegios root. Es como pasar por torniquetes dentro del mismo edificio. No salimos a la calle (es decir, a una nueva subred) ni obtenemos las llaves de todas las puertas (privilegios root), pero en cada nuevo punto de control vuelven a revisar nuestro pase, porque detrás de ese torniquete rigen otras reglas de seguridad. A veces el límite pasa entre dos roles dentro de un mismo proceso, a veces entre la API y un worker y, a veces, entre la máquina virtual invitada y el hipervisor. En cuanto al límite entre la API y el worker, puede surgir una vulnerabilidad por diferencias en el procesamiento de datos: la API interna de la nube recibe del usuario una cadena de texto con un byte nulo (\x00), la considera válida y la transmite, mientras que el worker en segundo plano confía ciegamente en esos datos y los inserta en una consulta de bajo nivel al SGBD PostgreSQL. Como para las bibliotecas en lenguaje C el carácter \x00 indica el final definitivo de la cadena, el handler de la base de datos trunca el texto en el punto donde se inyectó ese byte, lo que rompe la lógica de la consulta SQL o de la verificación de permisos, descarta el contexto del usuario común y hace que el sistema cambie la contraseña del administrador principal (postgres), lo que lleva a la toma total de control de la base de datos.
Ejemplo 1. Aislamiento estricto (SGBD administrado)
El cliente renta una base de datos administrada en su tenant. Puede ejecutar consultas SQL, pero no puede conectarse al sistema operativo en el que se ejecuta. Aquí el límite de confianza pasa entre los permisos del rol en el SGBD y el entorno de ejecución de su proceso. Si, mediante las consultas SQL permitidas, el pentester logra pasar a la ejecución de código a nivel del sistema operativo en nombre del proceso de servicio, el investigador obtiene acceso completo a los recursos del host. Esto le permite no solo recopilar información, sino interactuar activamente con el host: leer y modificar archivos, analizar los procesos en ejecución, establecer conexiones de red con servicios internos y extraer credenciales (por ejemplo, el token de la cuenta de servicio IAM) para atacar otros componentes de la nube.
Ejemplo 2. Acceso legítimo (máquina virtual administrada)
En otra implementación, el proveedor admite de forma nativa la autenticación mediante clave SSH, y el usuario se conecta al recurso como si fuera una máquina virtual común. El producto sigue llamándose “SGBD administrado”, pero el límite de confianza real se desplaza a un nivel más profundo: el de la interacción entre el sistema operativo invitado y la infraestructura del host. En este caso, el acceso al sistema operativo por SSH no constituye una vulneración, ya que está previsto en el modelo del servicio. Es necesario verificar el siguiente límite: entre la máquina virtual de servicio y los agentes de administración, los metadatos, el host o el plano de control.
De ello se derivan varias reglas prácticas:
- La ejecución normal de código del usuario no demuestra por sí misma una vulneración del aislamiento. En servicios de TI como los notebooks interactivos (notebook), los ejecutores de tareas de integración continua (CI runner) o los sistemas serverless, la ejecución de código es una función del producto.
- Obtener privilegios máximos dentro de un pod no equivale a tener privilegios máximos en el nodo. Después de cada cruce de un límite de confianza (por ejemplo, hacia una zona con otros privilegios y cuentas de servicio), es necesario volver a determinar los procesos visibles, los puntos de montaje, las interfaces, los dispositivos y las cuentas de servicio IAM.
- Un token de cuenta de servicio IAM encontrado no es necesariamente útil para el investigador. Lo importante es quién lo emitió y qué sistemas lo aceptan. También influyen el tenant o el servicio al que está vinculado y las acciones permitidas en ellos.
- El simple hecho de que desde un contenedor del cliente se pueda acceder a una dirección IP interna del proveedor no implica todavía un compromiso. En muchas nubes, parte de los servicios internos es accesible por red de forma normal. Para lograr el compromiso, el atacante necesita interceptar un token de servicio o encontrar un servicio interno que acepte por error cuentas de clientes o que no requiera autenticación.
- La ejecución remota de código dentro del entorno donde funciona el servicio no implica todavía acceso al plano de control. Es solo la zona inicial, desde la cual el investigador debe buscar el siguiente límite de confianza: tokens de servicio, API internas del proveedor, contenedores vecinos.
Para distinguir una vulneración real del límite de confianza de un falso positivo, utilizamos cuatro etapas desde la perspectiva del investigador:
- Visibilidad de red. El investigador ve un servicio interno del proveedor desde el entorno del cliente. Esto todavía no es una intrusión, pero es la primera señal de que el aislamiento puede ser insuficiente.
- Autenticación. El investigador logra “presentarse” ante un servicio que acepta un token o certificado comprometido en el paso anterior (por ejemplo, el token de una cuenta de servicio o de metadatos). Esto ya es grave, pues el servicio considera legítima la solicitud.
- Autorización. El objetivo del ataque otorga permisos específicos al contexto actual. Todavía no se trata de ejecutar operaciones peligrosas, sino de verificar que están permitidas.
- Acción controlada más allá del límite de confianza original. El investigador realiza una acción mínima y segura que confirma que los permisos obtenidos funcionan en la práctica: por ejemplo, crea un registro de prueba en un tenant vecino (normalmente, un segundo tenant de prueba).
Las dos primeras etapas solo ofrecen una hipótesis sobre el cruce del límite de confianza. El objetivo es visible en la red y acepta solicitudes, pero eso no significa que el investigador pueda modificar algo en él. El impacto confirmado solo aparece en las dos últimas etapas, cuando se logra la autorización y se ejecuta una acción controlada más allá del límite original. Por ejemplo, la accesibilidad de red de un SGBD vecino indica un aislamiento de red insuficiente, pero el impacto entre tenants solo surge cuando, desde el contexto original, es posible ejecutar sobre un recurso de otro tenant una acción no permitida por el modelo de la nube, como la lectura de datos. Por razones de hacking ético, el investigador demuestra esta lectura exclusivamente entre sus propias cuentas de prueba, para no vulnerar la confidencialidad de usuarios reales.
Modelo del atacante y tres objetivos de la investigación
La división de la infraestructura en la nube en tres niveles (External, Overlay, Underlay) ayuda a definir el modelo de atacante para cada uno de ellos. Durante la prueba de penetración, el investigador puede centrarse en un nivel y buscar todas las formas posibles de superar el límite de confianza más cercano. Otro enfoque consiste en construir una cadena de ataque completa a través de todos los niveles. El modelo de atacante también define el punto de partida: con qué nivel de acceso y desde qué posición comienza el pentest. A continuación, presentamos una lista universal de modelos de atacante aplicables a la mayoría de las infraestructuras en la nube:
- Atacante externo sin cuenta. Se verifican la superficie pública, el registro, el mecanismo de inicio de sesión, los servicios accesibles desde el exterior y la ruta hacia el primer contexto de cliente. Nivel External.
- Atacante con acceso legítimo al tenant. Es el modelo clave para una nube multitenant: el cliente tiene derecho a crear sus propios recursos e intenta salir de sus límites. Nivel External.
- Atacante interno con un entorno de ejecución (runtime) comprometido. El punto de partida es un proceso, un pod o una máquina virtual infectados. El escenario es especialmente relevante para los ataques a la cadena de suministro. El investigador estudia las posibilidades de movimiento lateral en el entorno de red y de host. Nivel Overlay o Underlay.
- Atacante interno con un token de cuenta de servicio IAM o una cuenta de operador comprometidos. Este modelo contempla la verificación de IAM y de los procesos de administración de la plataforma en la nube. Nivel Overlay o Underlay.
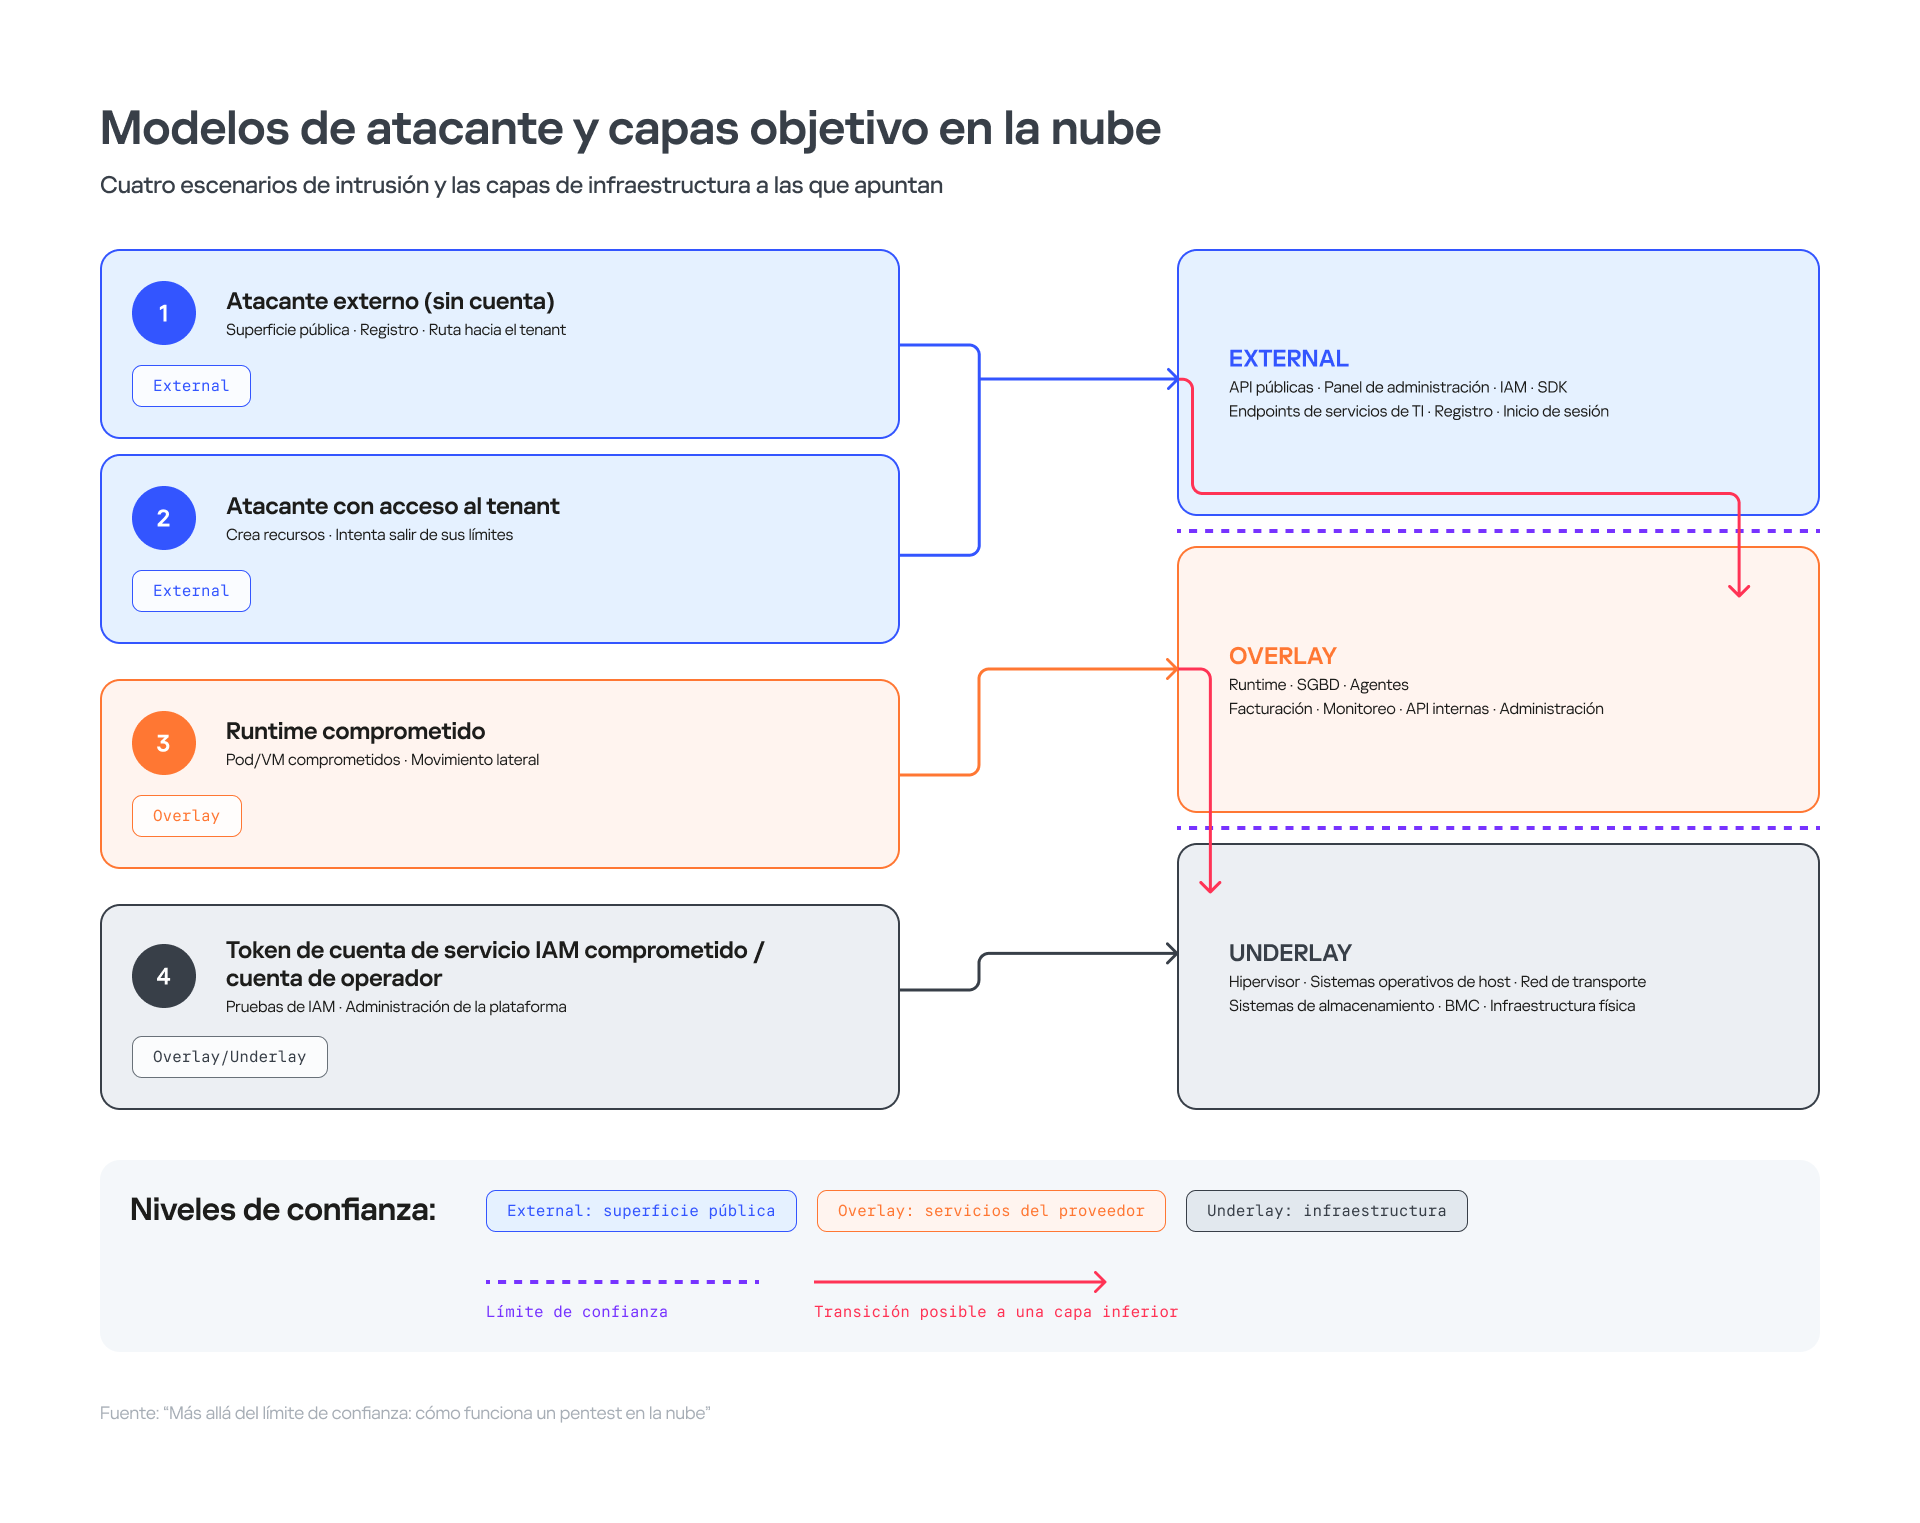
Independientemente del modelo de atacante y del punto de entrada inicial, los objetivos de la investigación en la etapa inicial pueden dividirse en tres grupos.
1. Primero, la ejecución de código
El objetivo de este enfoque es ejecutar código arbitrario dentro de un entorno administrado por el proveedor. Para ello, el pentester puede atacar, por ejemplo, una base de datos administrada, una función serverless, una carga de trabajo de CI/CD, una aplicación PaaS, una máquina virtual del cliente, un contenedor o un gateway de red virtual.
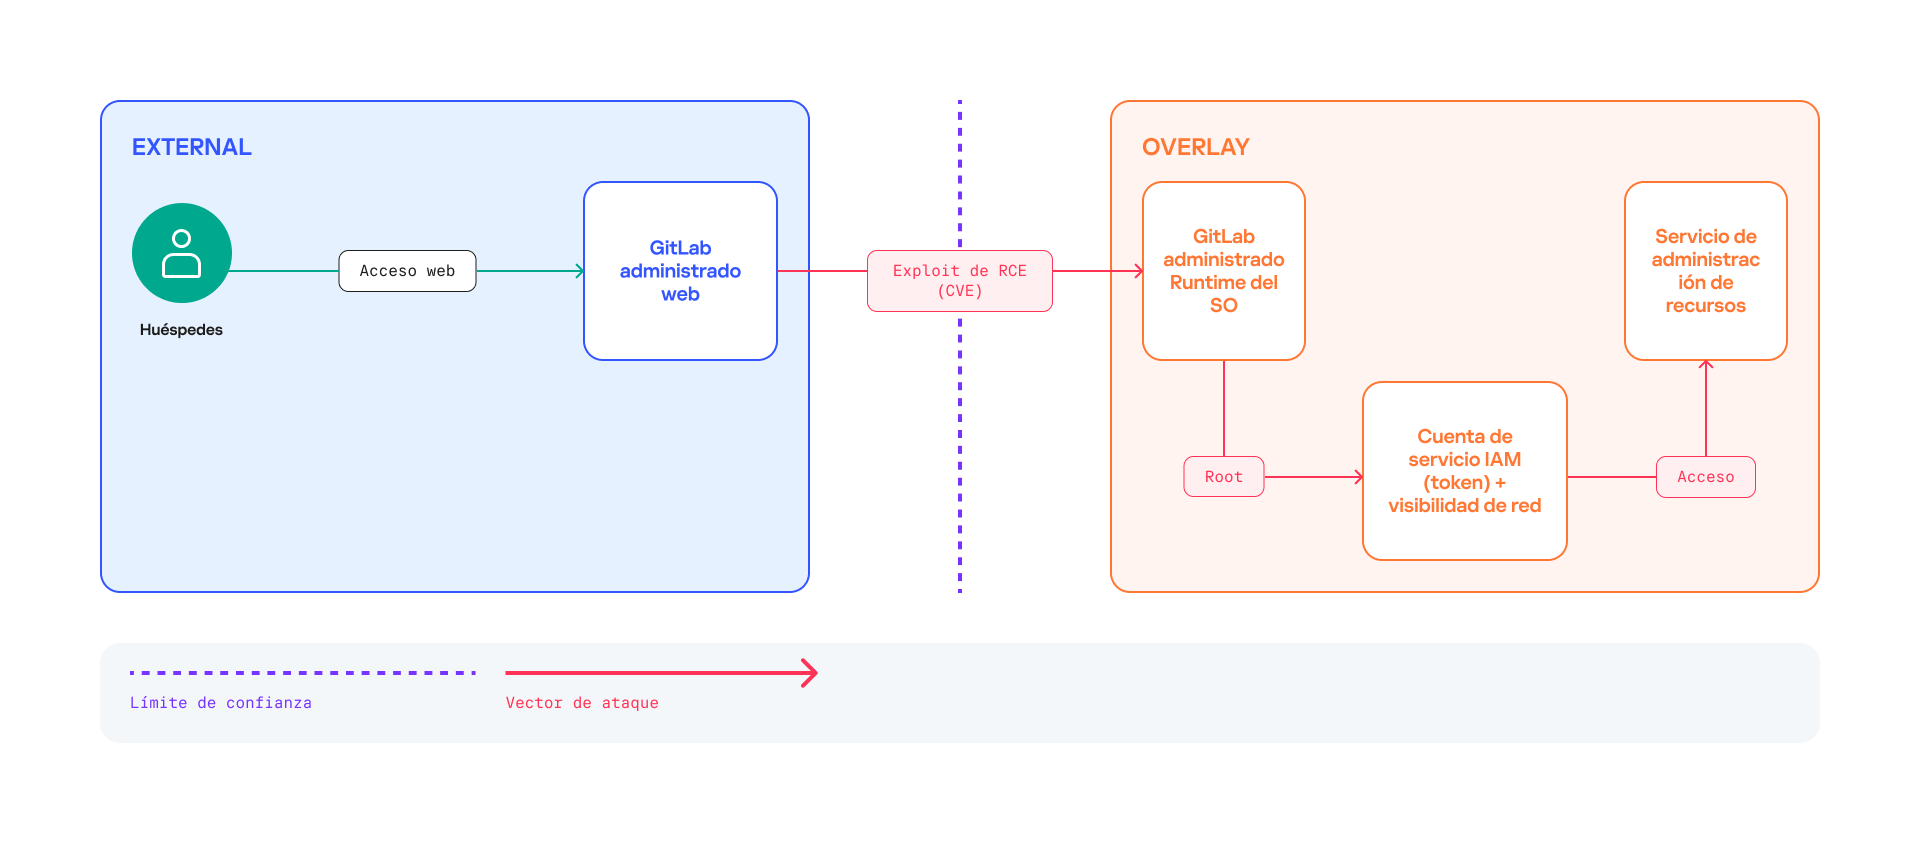
Ejemplo de cadena de ataque a través de un servicio administrado
El pentester interactúa con la interfaz del servicio administrado e identifica una vulnerabilidad en ella (por ejemplo, CVE-2026-19478, como en el caso de la interfaz web de GitLab) o en los módulos adicionales que implementó el proveedor de nube. La vulnerabilidad permite al investigador ejecutar código de forma remota dentro del entorno de ejecución (en el sistema operativo), encontrar una cuenta de servicio IAM y, gracias a ella, obtener acceso al servicio de administración de recursos. Después, el investigador puede buscar vulnerabilidades en ese servicio y penetrar en el entorno interno del proveedor (es decir, en el nivel provider overlay).
Ejemplo de cadena de ataque a través del entorno virtual
La cadena comienza con el compromiso de una carga de trabajo del cliente (tenant workload). El investigador oculta previamente código malicioso en una imagen popular de sistema operativo o de contenedor. El cliente de la nube descarga esa imagen infectada y la ejecuta, con lo que el hacker obtiene acceso al interior de ese contenedor concreto. Después, encuentra formas de escapar del contenedor (mediante CVE-2026-43284) hacia el entorno de ejecución, ya sea el runtime de contenedores, el hipervisor o el agente del host. Desde allí, llega al host que comparte con otros contenedores y adquiere la capacidad de afectar los componentes de administración del proveedor.
2. Las credenciales
En lugar de acceso al entorno de ejecución, el investigador puede obtener credenciales que reconocen los servicios en la nube: el token de una cuenta de servicio, credenciales de acceso a los metadatos, un certificado mTLS, un token inicial (bootstrap) o una clave de almacenamiento de objetos.
En este escenario, el paso al entorno interno del proveedor no se produce por una vulneración del aislamiento de red, sino mediante funcionalidades legítimas de la plataforma. La red puede estar bien segmentada, pero un token de cuenta de servicio IAM con privilegios excesivos, que el atacante logró interceptar (por ejemplo, de variables de entorno o de los metadatos), permite invocar de forma legítima la API interna a través del gateway estándar o del servicio de intercambio de tokens.
3. Contexto administrativo o de servicio
El objetivo de este escenario es eludir las restricciones técnicas mediante un acceso legítimo por canales destinados al personal. La ruta suele comenzar con la explotación del factor humano (phishing, personas internas, filtración de accesos de empleados o contratistas). Sin embargo, el punto de entrada final al entorno interno es técnico: conexión mediante la VPN del operador, portal de soporte, herramienta de soporte remoto, estación de trabajo administrativa, certificado SSH o consola serial. Aunque la ruta suele comenzar con el compromiso de una persona, la zona inicial resultante (el contexto técnico con determinados privilegios y acceso a recursos en el que se encuentra el investigador) puede coincidir con la del primer escenario. Por ejemplo, el acceso al host de una base de datos administrada (DBaaS host) puede obtenerse no mediante la explotación de una vulnerabilidad, sino a través de un canal administrativo legítimo que luego se utiliza para escalar privilegios.
Entendiendo el zoológico arquitectónico
Tras avanzar hacia el interior de la infraestructura de la nube y obtener acceso a un nodo, el pentester analiza los artefactos locales. Detrás de un mismo servicio administrado pueden ocultarse arquitecturas completamente diferentes.
Infraestructura similar a OpenStack
En los servicios IaaS basados en OpenStack suele haber un amplio conjunto de componentes: cuenta de servicio IAM, recursos de cómputo, red, imágenes y almacenamiento en bloque (block storage), así como procesos de API, workers, un broker de mensajes (message broker) y bases de datos de estado de la plataforma. Un servicio administrado construido sobre esa capa IaaS puede usar una máquina virtual independiente para cada instancia de base de datos, varias instancias en una máquina virtual compartida, un clúster de Kubernetes sobre workers virtuales o incluso un tenant dedicado para un producto concreto.
Aunque la presencia, por ejemplo, del broker de mensajes RabbitMQ es característica de OpenStack, el simple hecho de detectarlo no demuestra que se trate de una instalación clásica de OpenStack. El proveedor pudo modificar el esquema de confianza, agregar una API propia y sustituir parte de los componentes.
Plataformas con arquitectura de Kubernetes
En las nubes de este tipo, un clúster central de Kubernetes controla toda la infraestructura: no solo los contenedores, sino también las máquinas virtuales, otros clústeres de Kubernetes de clientes y los servicios administrados. En el nivel del entorno de ejecución del servicio, el producto puede ser un pod en un espacio de nombres compartido, una aplicación dentro de un tenant, una máquina virtual de KubeVirt o un worker de un clúster independiente. Desde fuera, todas las variantes parecen un mismo producto, pero sus límites de confianza y la superficie de ataque posterior difieren radicalmente.
Como la administración de la plataforma se basa en un clúster de Kubernetes, donde la unidad principal de autorización es el token de la cuenta de servicio, es especialmente importante entender dónde se encuentra la cuenta de servicio IAM obtenida durante el pentest: en el clúster del cliente, en el clúster administrado o en el operador que atiende a varios tenants. Tokens de apariencia idéntica pueden tener permisos sobre un solo pod o permitir modificar recursos en varios entornos a la vez.
Plano de control propio y sistemas de administración de la configuración
El proveedor puede prescindir por completo de una solución empaquetada. Por ejemplo, en una arquitectura de este tipo, la API pública puede desarrollarse internamente, las máquinas virtuales pueden desplegarse mediante libvirt o una capa IaaS ligera, la administración de la red puede automatizarse con scripts en torno a Open vSwitch (OVS), el almacenamiento de objetos puede construirse sobre Ceph y la configuración de los nodos puede distribuirse mediante SaltStack u otro sistema de administración de la configuración.
En una arquitectura así, el servicio de administración de máquinas virtuales puede obtener la configuración de un servicio HTTP interno, el respaldo puede ejecutarse mediante un script con credenciales compartidas, la facturación puede recibir eventos de una cola y el agente interno puede interactuar con el plano de control mediante mTLS. Casi todos los componentes son específicos del proveedor, y la principal zona de riesgo no se relaciona con vulnerabilidades en productos conocidos (por ejemplo, basados en soluciones de código abierto), sino con errores lógicos en las uniones entre los sistemas internos.
Plataforma híbrida
En la práctica, lo más común es una combinación de enfoques, por ejemplo, de esta forma:
- El núcleo de la infraestructura (capa IaaS) está construido sobre OpenStack.
- Los servicios administrados utilizan Kubernetes.
- El sistema de almacenamiento funciona sobre Ceph.
- IAM, los sistemas de facturación y la API interna son una implementación propia.
Enumeramos algunos indicios que pueden ayudar a formular las primeras hipótesis sobre el entorno:
- La presencia, en el entorno de ejecución del host analizado, de un token de Kubernetes y del DNS del clúster permite suponer que el servicio funciona en el contexto de un pod;
- El proceso qemu-guest-agent en ejecución indica que nos encontramos dentro de una máquina virtual y no en un servidor físico;
- Los volúmenes Ceph/RBD montados señalan la existencia, en la arquitectura de la plataforma, de una capa de almacenamiento independiente (storage plane) implementada mediante almacenamiento en bloque distribuido;
- Una gran cantidad de interfaces de red CNI u Open vSwitch (OVS) significa que se trata de un nodo compartido (shared node) de Kubernetes, en el que pueden alojarse contenedores de otros clientes.
No obstante, cualquiera de estos indicios requiere pruebas de verificación adicionales.
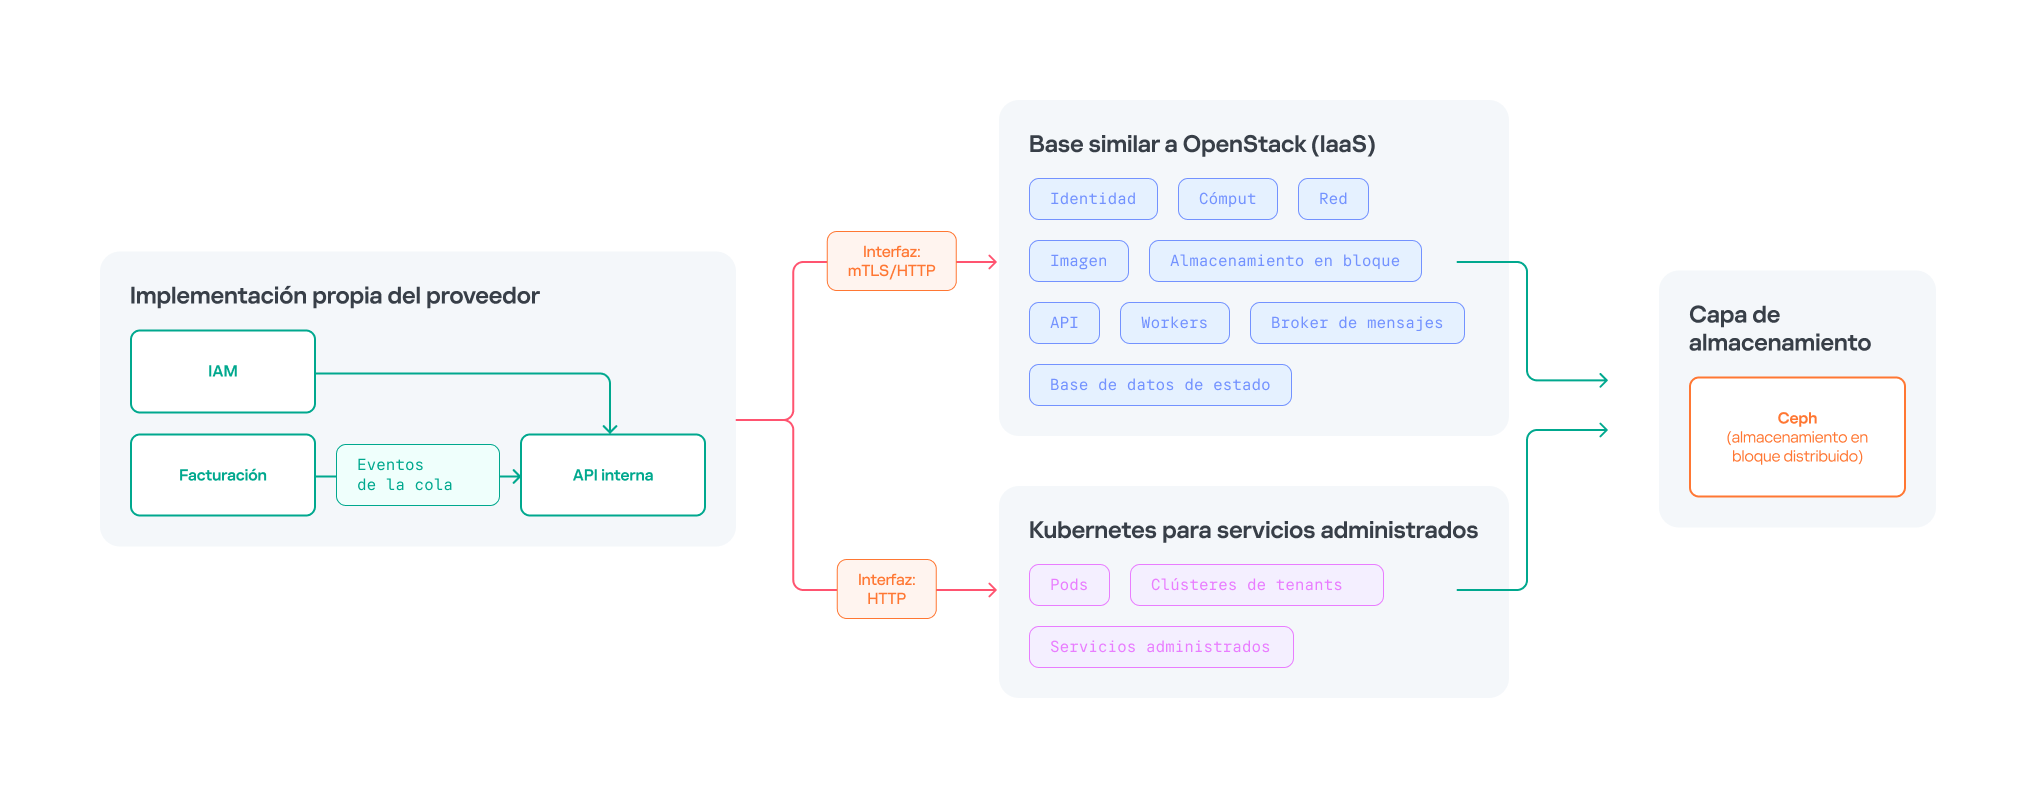
Ejemplo de implementación de una plataforma en la nube híbrida
Cómo elegir el siguiente límite de confianza
Después de que el pentester examina la zona inicial, la ruta siguiente se determina por la combinación de dos factores:
- Visibilidad de red: qué segmentos, servicios y tenants son alcanzables.
- Nivel de confianza disponible: qué credenciales, certificados y métodos de API se reconocen como válidos en esos segmentos.
A veces la red casi no tiene restricciones, pero todos los servicios exigen una autenticación mTLS correcta. En otro caso, la red está casi cerrada, pero la cuenta de servicio encontrada puede crear recursos en toda la región mediante la API estándar. Por eso, la accesibilidad de red (puertos abiertos) y la cuenta de servicio IAM deben analizarse en conjunto.
En esta etapa, el investigador suele centrarse en varias líneas críticas de investigación:
Telemetría (observability): se verifica si los sistemas centralizados de monitoreo (registros, métricas, trazas) recopilan datos de distintos tenants y si existe un aislamiento suficiente entre ellos. El riesgo de vulneración del aislamiento aparece si es posible buscar por identificadores ajenos, leer registros de eventos sin procesar, extraer credenciales de los eventos de telemetría o influir en las alertas y las acciones automáticas.
Sistemas de almacenamiento y respaldo de datos: esta capa conecta el entorno de ejecución, el plano de administración (management plane) y los datos del usuario. El investigador analiza el alcance de las claves, la vinculación de las instantáneas y los respaldos con los tenants, los volúmenes temporales de restauración (restore volumes) y la forma en que los workers determinan al propietario del recurso.
Sistema de facturación y cuotas: se verifica si la desincronización entre el inventario y la contabilización puede derivar en cómputo no facturado, evasión de cuotas o agotamiento de los recursos del proveedor. Aquí un impacto crítico no requiere necesariamente la ejecución remota de código.
IAM y cuenta de servicio: el pentester evalúa si el token puede abrir una ruta a través de un gateway público o interno, incluso con una segmentación de red estricta. Se presta especial atención al alcance, a la vinculación con el tenant, al acceso al almacén de secretos y a la vigencia del token.
Cadena de suministro: se verifican los repositorios de imágenes de contenedores y máquinas virtuales, los repositorios de paquetes de instalación de utilidades y de administradores de paquetes de Kubernetes, así como la configuración de las herramientas de CI/CD. El acceso de escritura a cualquiera de estos componentes a veces genera un impacto mayor que la ejecución remota de código en un solo nodo.
Servicios de administración: el investigador estudia los planificadores de tareas, las colas de mensajes, los servicios de inventario y los sistemas de administración de la configuración. Si se logra obtener la confianza de un componente de este tipo, ya no es necesario conectarse directamente a cada instancia del servicio, porque el propio componente puede entregar comandos y cambios a otros recursos.
Cadenas de ataque típicas e incidentes reales
En la práctica, los escenarios de ataque rara vez se repiten, pero algunos ejemplos muestran bien cómo los atacantes superan los límites de confianza.
1. De una base de datos administrada a los datos de otros usuarios
El investigador despliega su propia base de datos administrada y utiliza operadores y procedimientos SQL estándar para crear consultas SQL. Sin embargo, debido a una brecha en el aislamiento, la ejecución de código sale del entorno de ejecución aislado y se traslada al entorno de ejecución compartido del servicio. Allí se encuentra un token de cuenta de servicio IAM que no está vinculado a una instancia concreta de la base de datos administrada. La vulneración del aislamiento se confirma con la manipulación exitosa de la base de datos de otro tenant (de prueba).
En este caso, la posibilidad de ejecutar consultas SQL no era en sí una vulnerabilidad. La transición crítica se produjo entre el contexto del tenant y la cuenta de servicio IAM compartida. El resultado del ataque fue un impacto entre tenants que ni siquiera requirió obtener privilegios root en el host.
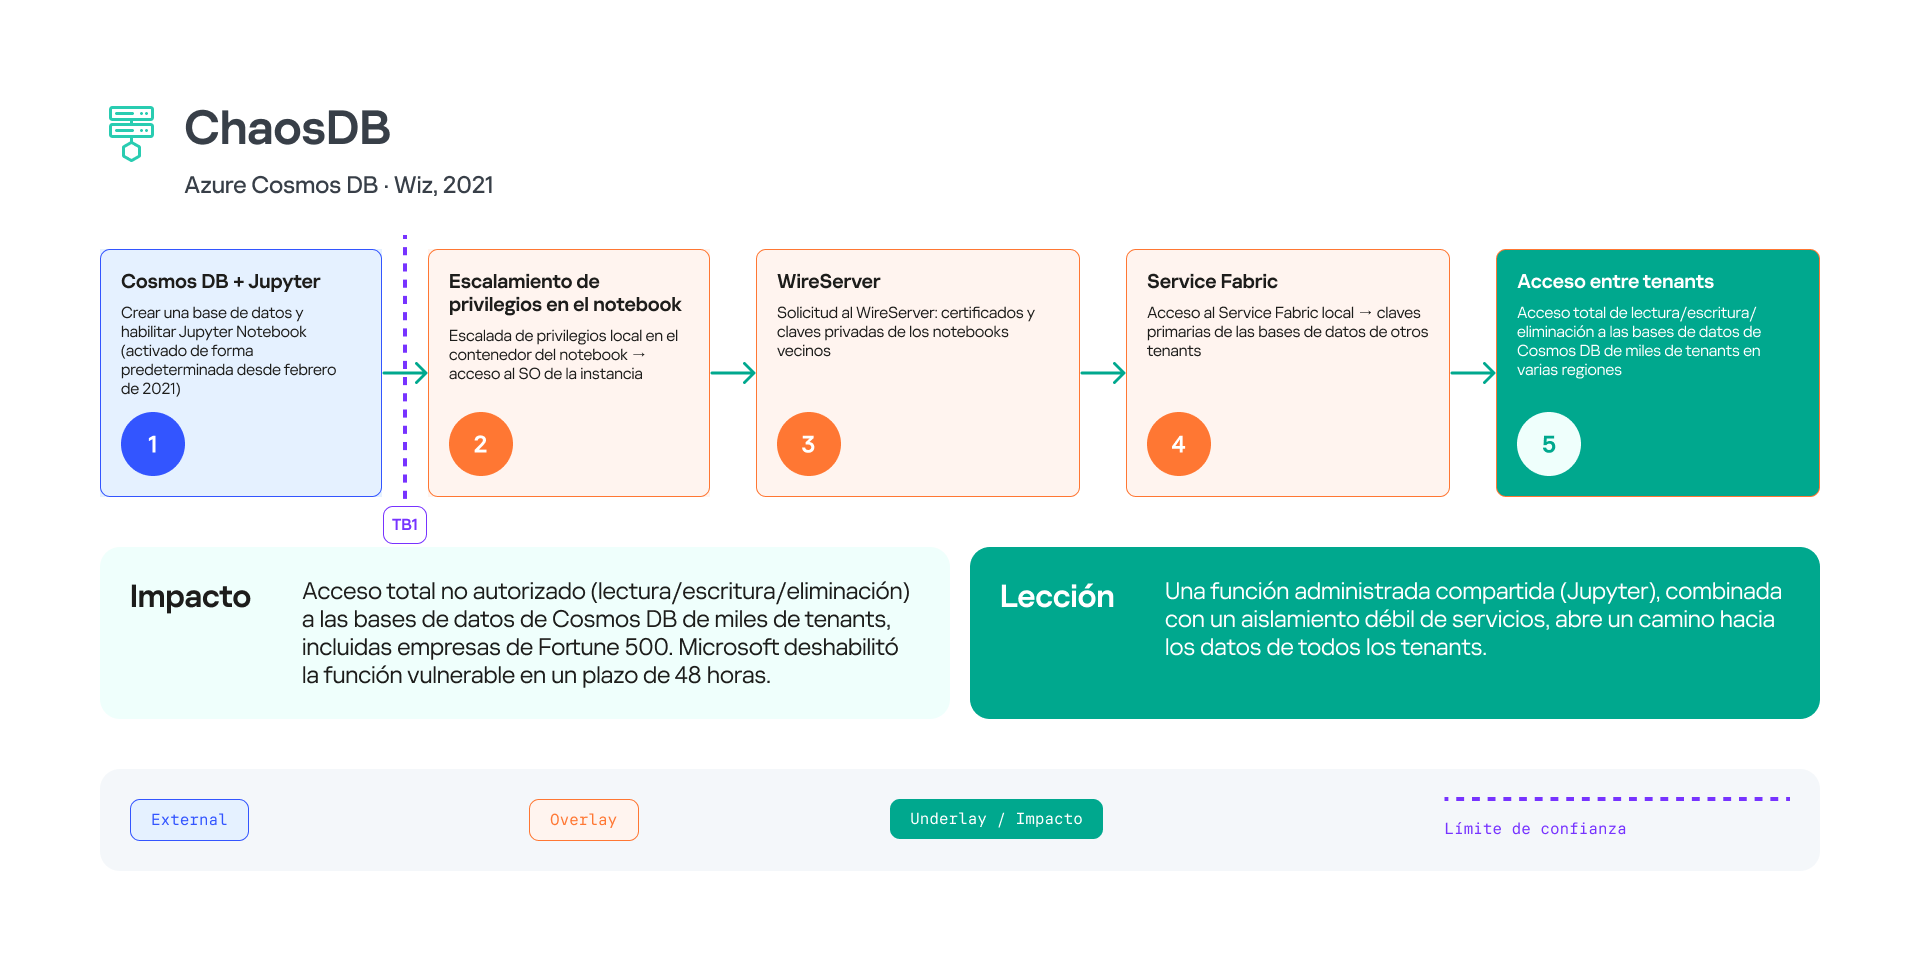
Una lógica similar se demostró en el caso público ChaosDB: la función Jupyter Notebook de Azure Cosmos DB generaba el riesgo de acceso a las claves de otros clientes. Este ejemplo es importante porque una vulnerabilidad en una función de usuario concreta de un servicio administrado afectó a otros componentes de la plataforma.
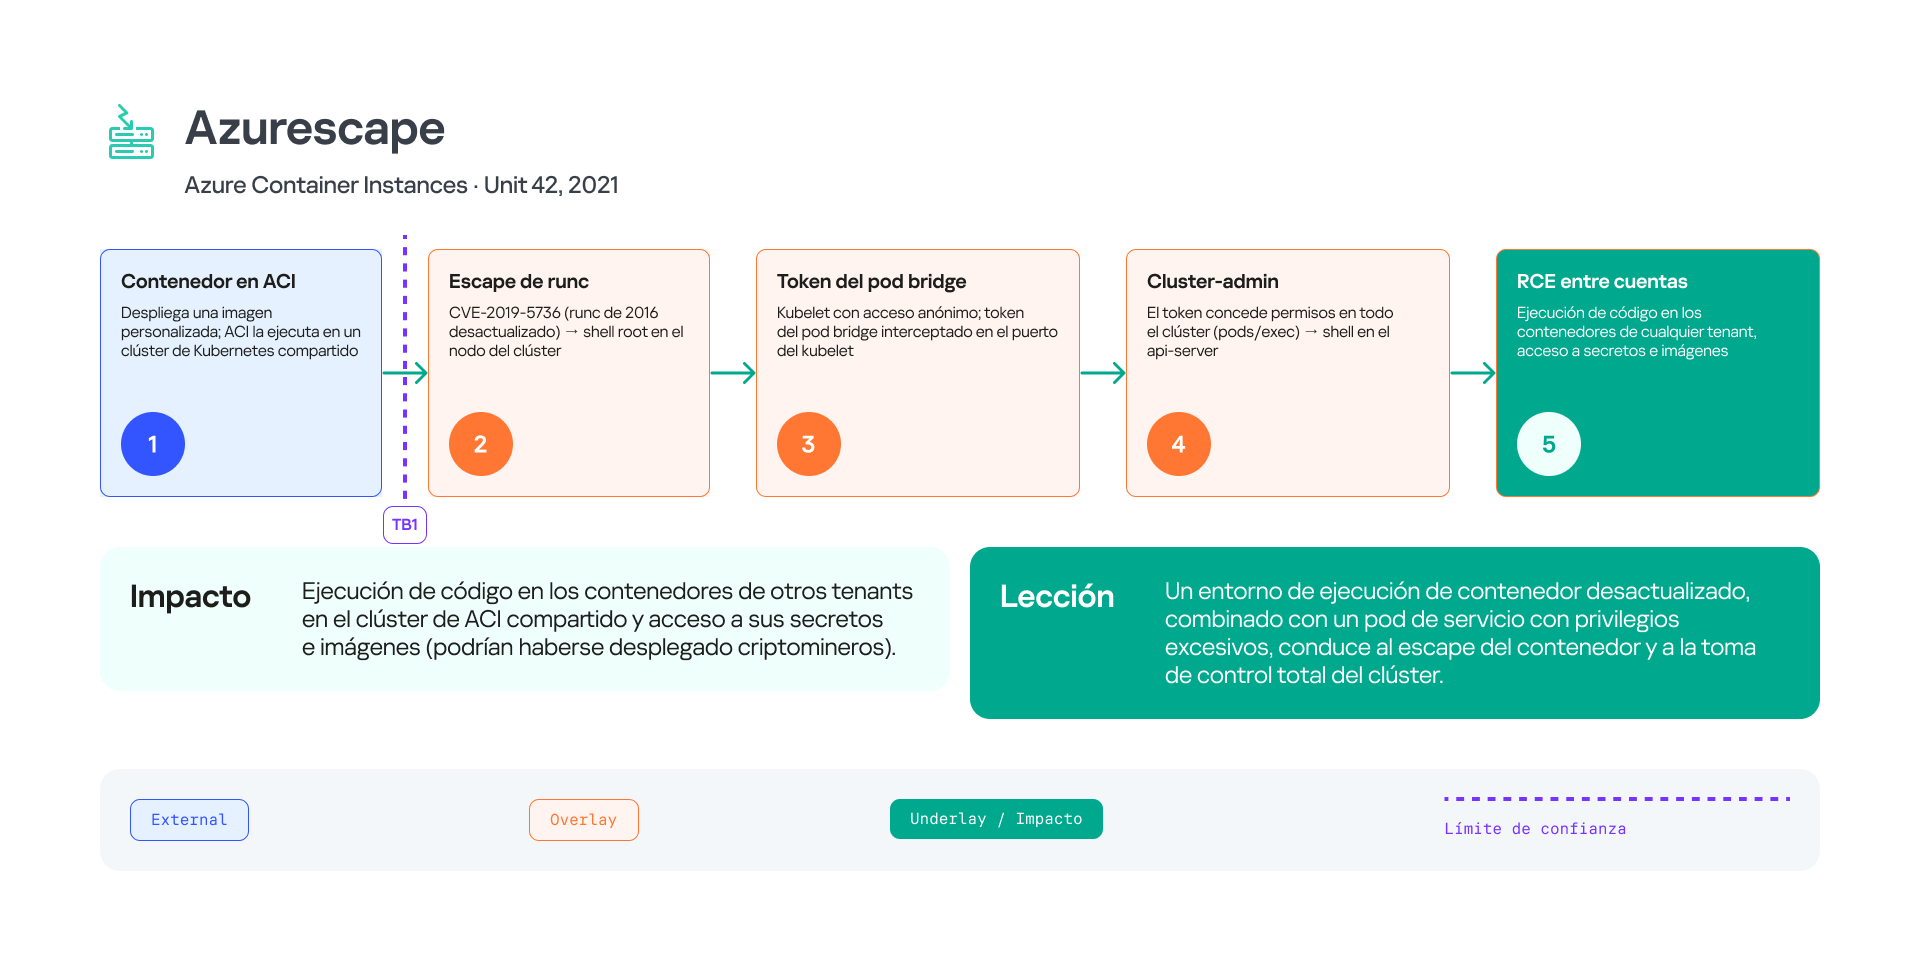
2. De un pod de Kubernetes a los datos de otros usuarios
El pentester ejecuta su propio contenedor y, mediante una vulnerabilidad de aislamiento, toma el control del host subyacente. En el host se encuentra una cuenta de servicio privilegiada de Kubernetes que procesa solicitudes de la API del clúster de administración. Una acción controlada sobre un pod vecino, perteneciente al segundo tenant de prueba, confirma la vulneración del aislamiento.
Así fue precisamente la cadena Azurescape, publicada por Unit 42: escape del contenedor, obtención de una cuenta de servicio IAM privilegiada y compromiso de un clúster multitenant de Kubernetes. El hecho principal no fue el escape del contenedor, sino la posibilidad de obtener un token de cuenta de servicio válido para otros tenants.
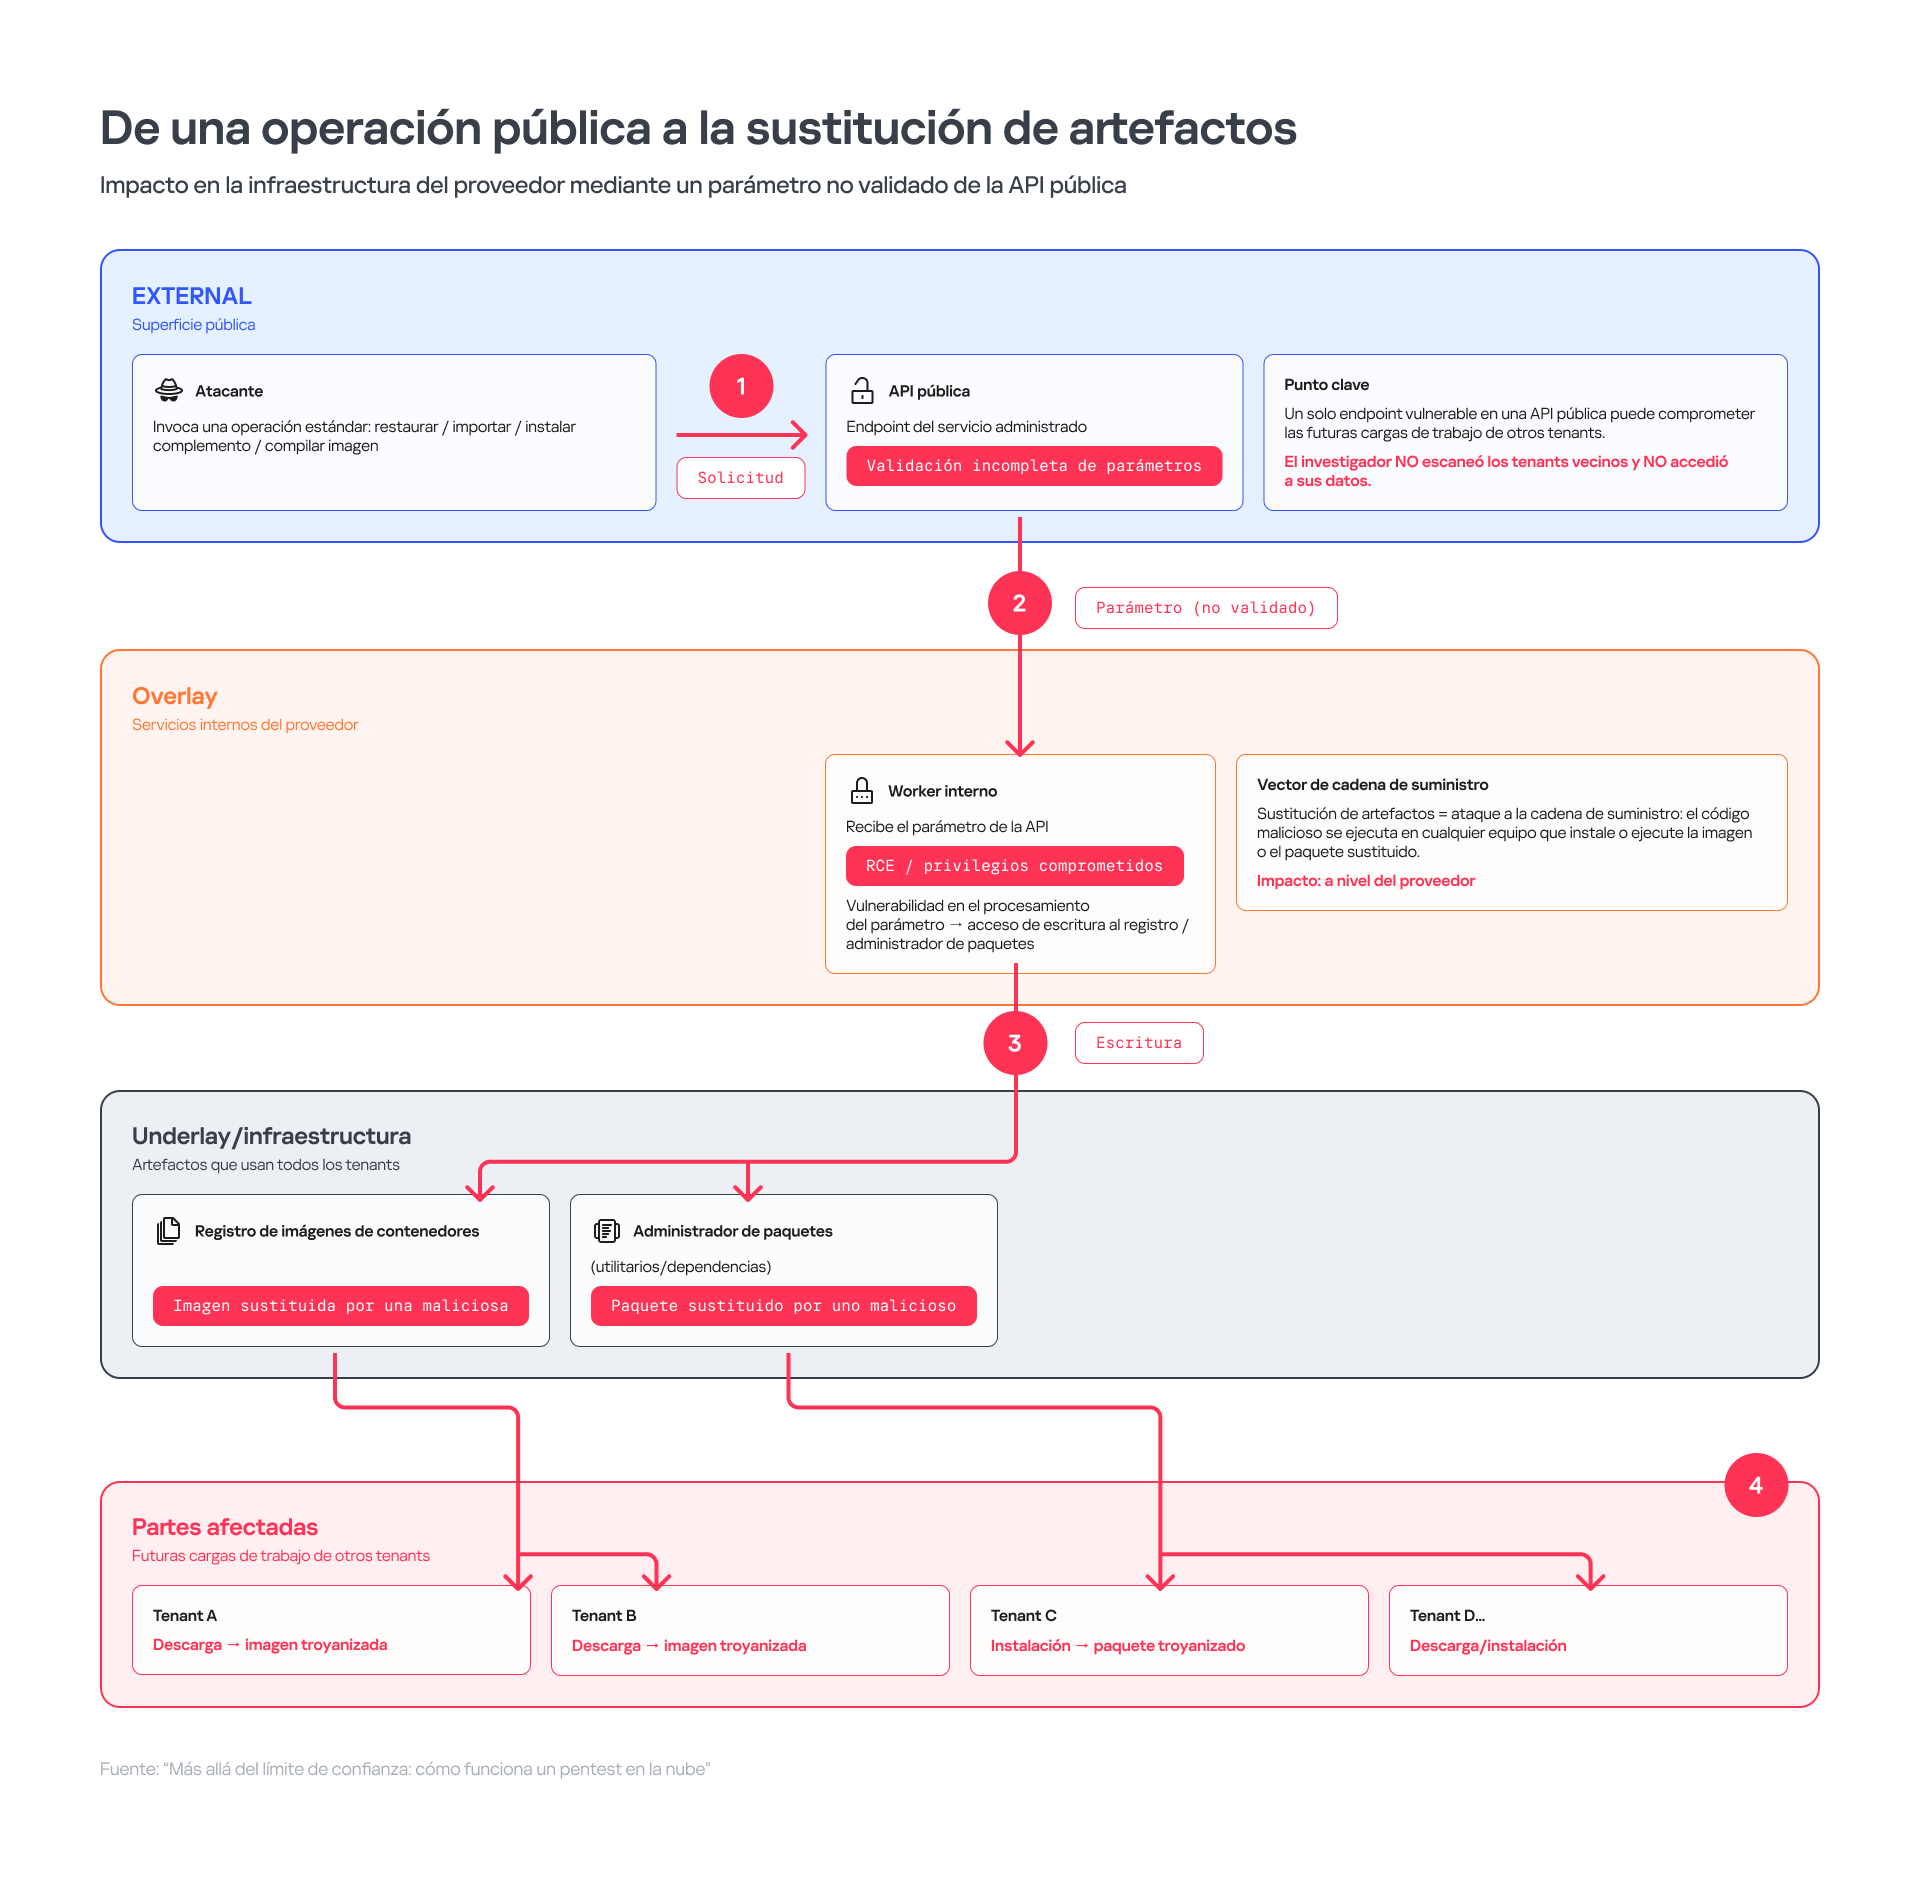
3. De una operación pública a la modificación de recursos internos de la nube
El usuario invoca una operación estándar de restauración, importación, instalación de complementos o compilación de imágenes para algún servicio administrado. La API pública no valida con suficiente rigor el parámetro que se transmite al worker interno. La explotación de una vulnerabilidad en el propio worker conduce a la ejecución remota de código o al compromiso de permisos (obtención de acceso de escritura al registro de imágenes de contenedores o al administrador de paquetes), lo que permite sustituir el artefacto de destino por uno propio.
Este es un ejemplo de impacto a nivel de la infraestructura del proveedor de nube: un endpoint (worker) de la API pública puede comprometer futuras cargas de trabajo de otros clientes, aunque el investigador no haya escaneado los tenants vecinos ni accedido a sus datos.
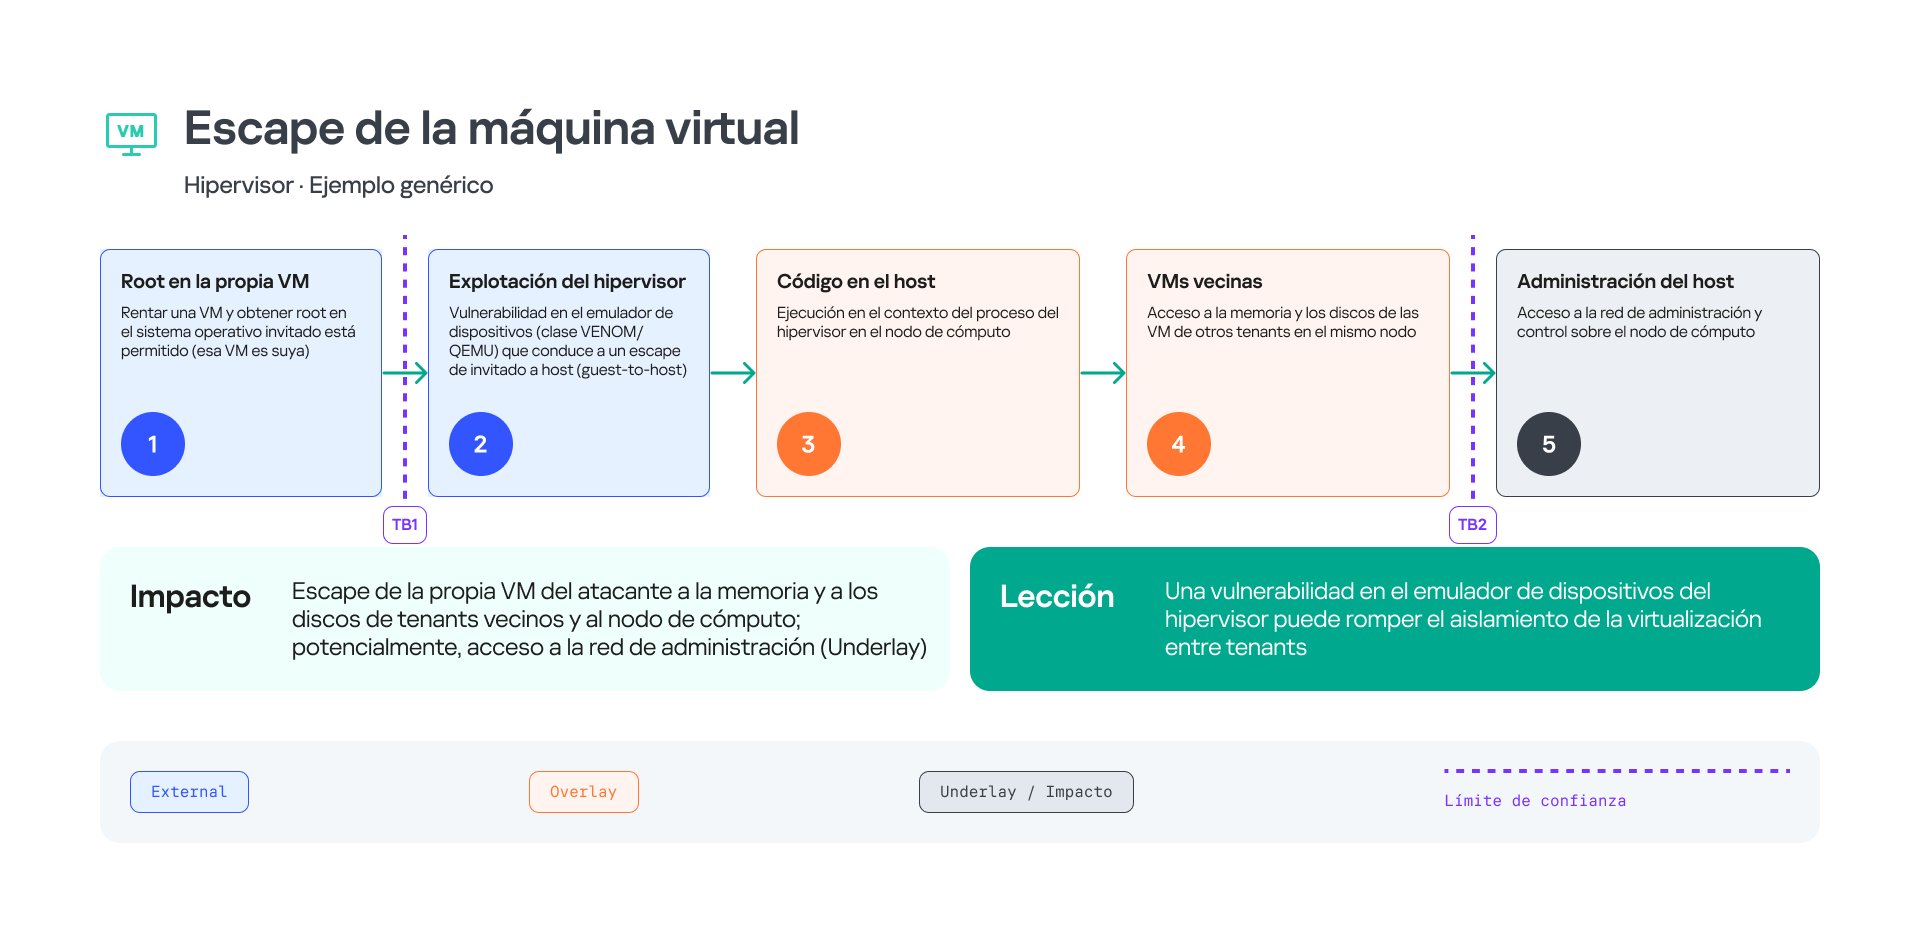
4. Escape de la máquina virtual
El punto de partida de la investigación es la propia máquina virtual del pentester en la nube. Descubrir una vulnerabilidad en el sistema de virtualización permite aplicar el vector guest-to-host (“de invitado a host”) y ejecutar código arbitrario en la máquina host del propio hipervisor. Después, el investigador pasa del host del hipervisor a la red de administración o al plano de control, lo que se considera el cruce del siguiente límite de confianza.
Las investigaciones públicas muestran que el escape de los sistemas de virtualización es una clase real de amenazas. Con mayor frecuencia, se relaciona con errores en los mecanismos de uso compartido de memoria y con vulnerabilidades en búferes de intercambio compartidos o en carpetas compartidas. Sin embargo, la existencia de una CVE pública no demuestra que una nube concreta sea vulnerable. Para que el ataque tenga éxito también influyen la versión del hipervisor, la configuración y la presencia de capas de protección adicionales (por ejemplo, políticas estrictas a nivel del sistema operativo). Probar técnicas “de invitado a host” en una infraestructura pública compartida implica un alto riesgo de impacto destructivo sobre el propio hipervisor y sus máquinas virtuales; por eso, estas pruebas están estrictamente reguladas y solo se realizan con el acuerdo del proveedor.
Qué se considera resultado del pentest
El valor de una prueba de penetración de entornos en la nube no se determina por la cantidad de puertos encontrados ni por el hecho de ejecutar comandos remotos, sino por la superación comprobada de los límites de confianza. Nuestra práctica muestra que, a partir de los resultados del pentest, los proveedores de nube esperan obtener respuestas a las siguientes preguntas críticas:
- ¿puede un atacante desde un tenant leer, modificar o eliminar datos de otros clientes?
- ¿es posible, mediante código del usuario, interceptar el token de la cuenta de servicio IAM del proveedor o realizar acciones en su nombre?
- ¿el compromiso de un entorno de ejecución permite propagar el ataque a otros recursos, servicios, a la celda o a la región?
- ¿es posible afectar los recursos tecnológicos internos del proveedor desde segmentos con un nivel de confianza bajo (por ejemplo, directamente desde una máquina virtual del cliente)?
- ¿es posible pasar del entorno virtual al host, al hipervisor, al sistema de almacenamiento o a la red física, y cuál es el alcance real del impacto destructivo?
Para cada vector de ataque confirmado se documentan las condiciones iniciales, las observaciones, las explicaciones alternativas, la prueba mínima suficiente, las limitaciones y el daño potencial. Un resultado negativo también es importante: muestra qué límite de confianza se basa en supuestos ciegos y cuál en mecanismos de control capaces de resistir en la práctica intentos dirigidos de evasión.
Confirmación segura del impacto
La verificación del entorno interno del proveedor y de la capa de infraestructura se diferencia de las pruebas habituales de una aplicación externa por el costo de un error. Cualquier acción descuidada puede provocar un efecto cascada y afectar una cola de mensajes compartida, un clúster de administración, los respaldos de varios clientes o un host compartido.
Antes de comenzar el trabajo, es necesario establecer en las reglas de interacción (Rules of Engagement):
- las cuentas, los tenants, las regiones y los componentes de infraestructura permitidos;
- las técnicas de ataque admisibles y los límites de intensidad de carga;
- las ventanas de tiempo para las pruebas, los canales de comunicación operativa y las condiciones para detener el trabajo de inmediato;
- las reglas para el manejo de cuentas bloqueadas, credenciales e información confidencial descubierta de forma accidental;
- el procedimiento para verificar hipótesis que salgan del alcance inicial de la investigación.
Insistimos en que es más seguro confirmar el impacto entre tenants en un segundo tenant controlado por el equipo de pentesting, con datos sintéticos preparados de antemano. El impacto a nivel del proveedor se verifica en un recurso o artefacto de prueba especial, creado específicamente para ello. La observación pasiva es preferible a la lectura de datos ajenos, y una acción mínima reversible es preferible a una explotación amplia.
Es importante distinguir dos formatos de trabajo. El propietario de un tenant puede probar sus propios recursos dentro de las reglas de cada nube, pero eso no siempre le da derecho a investigar la infraestructura del proveedor. El pentest del entorno interno del proveedor y de la capa de infraestructura requiere una autorización independiente por parte del propietario de la plataforma.
Conclusión
La tarea principal de una plataforma en la nube no es solo asignar recursos con rapidez, sino aislar de forma segura a los clientes entre sí y delegar la administración en la automatización del proveedor. El pentest externo clásico solo muestra la posibilidad de intrusión a través de la superficie de ataque pública. Sin embargo, la fiabilidad real de la propia nube depende de si las barreras de protección resisten los ataques en los límites de confianza entre los siguientes perímetros de la plataforma:
- External (nivel externo): superficie de ataque pública que incluye las API públicas, los paneles de administración, los servicios IAM, los endpoints de interacción con los servicios de TI y los SDK. Aquí, el pentest evalúa la posibilidad de obtener acceso inicial al entorno del cliente (tenant) y de comprometer cuentas.
- Overlay (servicios de TI): capa virtual del lado del cliente, donde funcionan los entornos de ejecución (runtime), los sistemas operativos, los SGBD y los agentes de servicio. Aquí las verificaciones buscan vulnerar el aislamiento del runtime y detectar privilegios excesivos de las cuentas de servicio IAM. Recordemos que introdujimos también un segundo nivel Overlay, ya que el entorno de ejecución del servicio del cliente y la infraestructura interna del proveedor tienen límites de confianza y puntos de entrada distintos. Lo abordamos a continuación.
- Overlay (componentes del proveedor): entorno lógico interno de la nube. Incluye los sistemas de facturación, respaldo, monitoreo y control de acceso, así como las API internas. Los ataques en este nivel buscan vulnerar los límites entre servicios/tenants y encontrar formas de interacción no autorizada con el plano de control.
- Underlay (capa de infraestructura): la base de la plataforma. Incluye los sistemas operativos de host, los sistemas de virtualización (hipervisores), la red de transporte, los sistemas de almacenamiento de datos, los controladores de administración de hardware (BMC) y otros mecanismos de bajo nivel. El objetivo de las verificaciones es evaluar el aislamiento de la virtualización y el alcance real del impacto sobre las cargas de trabajo vecinas.
Por eso, un pentest eficaz en la nube se construye como una secuencia de transiciones verificables entre estas zonas. En cada paso, el investigador documenta el punto de partida, describe el nuevo contexto obtenido, analiza sus cadenas de confianza y realiza la acción mínima necesaria para confirmar que ha superado el siguiente límite de confianza.
Este enfoque sistemático permite convertir hallazgos técnicos aislados en un riesgo medible y comprobado para un usuario concreto, un servicio o toda la plataforma en la nube.
Qué veremos en el próximo artículo
En este artículo hemos abordado las líneas generales de nuestro enfoque: los distintos niveles de la infraestructura en la nube y la ubicación de los límites de confianza entre ellos. En el segundo artículo, analizaremos en detalle la capa externa de la nube y el pentest de los servicios administrados desde la perspectiva del cliente.


Índice
- Puntos clave
- Términos principales
- Qué debe verificar el pentester
- La plataforma en la nube como objeto de investigación
- La analogía del hotel y los tres niveles de la nube
- Por dónde pasan los límites de confianza
- Modelo del atacante y tres objetivos de la investigación
- Entendiendo el zoológico arquitectónico
- Cómo elegir el siguiente límite de confianza
- Cadenas de ataque típicas e incidentes reales
- Qué se considera resultado del pentest
- Confirmación segura del impacto
- Conclusión
- Qué veremos en el próximo artículo
De los mismos autores
En la misma categoría


Más allá del límite de confianza: cómo funciona un pentest en la nube