

Autores
La protección de los sistemas de información en una organización moderna depende de un conjunto de tecnologías que generan miles de alertas de seguridad cada día. Al examinar el conjunto de alertas, se observa que una parte considerable corresponde a falsos positivos. Lo ideal es filtrarlas de forma automática para que el analista pueda concentrarse en las que pueden indicar un incidente real. Sin embargo, escribir los filtros también es una tarea laboriosa. Para crear un filtro correcto, el analista debe:
- examinar los registros;
- identificar el origen de la actividad;
- definir los límites del filtrado;
- elegir los criterios de filtrado;
- escribir la regla;
- comprobar la solidez del filtro.
En este artículo analizamos cómo automatizar la creación de los filtros para reducir la carga de trabajo del analista.
Criterios de validez de los filtros
En el contexto de las alertas de seguridad, un filtro es una combinación de valores de campos del evento que indica que la detección es un falso positivo y no requiere la atención del analista. Es posible generar filtros para cualquier combinación de campos del evento, pero no todas las combinaciones producen un filtro válido. Por eso es necesario definir criterios de validez, es decir, condiciones que permitan determinar si un filtro específico solo descarta las alertas que hacen ruido y no bloquea alertas útiles.
Por lo general, las reglas de detección de los sistemas de seguridad tienen un conjunto de condiciones, y cada una de ellas puede generar una alerta. Un evento concreto activa algún fragmento de la regla de detección. Llamaremos contexto al conjunto de eventos a los que reacciona ese fragmento concreto. Un buen filtro debe abarcar, en lo posible, todo el contexto y, al mismo tiempo, no rebasar sus límites. Los filtros demasiado amplios y los demasiado restrictivos resultan inútiles. Así, un filtro por PowerShell descartará demasiados eventos, incluso aquellos a los que el analista debería prestar atención. Además, la mayoría de los eventos filtrados no tendrá relación con la regla de detección concreta. Por otro lado, un filtro por un ID concreto abarcará un solo evento, que quizá nunca vuelva a ocurrir en el futuro.
Problemas que surgen al generar filtros
Al crear filtros, podemos enfrentar varios problemas. En primer lugar, los eventos suelen contener un número excesivo de campos (alrededor de 400 en promedio), y la mayoría no es necesaria para el filtrado. Además, generar combinaciones de estos campos y ordenarlas por relevancia es una tarea bastante laboriosa. Por eso, lo primero es descartar los campos que no nos interesan y conservar solo los que tiene sentido utilizar en el filtro. Así, de los 400 campos de un evento, pueden bastar cuatro para filtrar.
Otro problema es la normalización de cadenas. Los valores de los campos (por ejemplo, la ruta a una misma aplicación en distintos sistemas) pueden variar según la configuración de cada sistema, los nombres de las carpetas de usuario, etc. Para que el filtro tenga en cuenta todas estas variaciones, es necesario normalizar las cadenas. En particular, en las rutas de archivos se puede sustituir la letra de la unidad y las carpetas de usuario por variables de entorno estandarizadas, y convertir todas las rutas a mayúsculas o todas a minúsculas.
Por último, si el filtro reproduce por completo la consulta de la regla de detección, en la práctica desactiva esa regla. Este problema se resuelve eliminando del filtro los campos del evento que se utilizan en la regla de detección. Por ejemplo, si la regla se activa por la ruta de un archivo, se pueden filtrar las alertas no deseadas de dos maneras:
- Usar en el filtro campos distintos de la ruta del archivo
- Usar en el filtro un fragmento de la ruta del archivo que no intervenga en la regla. Por ejemplo, para la regla
file_path: ".../something.exe"se puede configurar un filtro que excluya los eventos cuya ruta de archivo contenga el directoriouser/unique_files/.
Filtrado de alertas de seguridad mediante un algoritmo
Tomando en cuenta los problemas descritos, la generación automática de filtros para alertas de seguridad debe constar de los siguientes pasos:
- El analista recibe una alerta de seguridad, la evalúa como falso positivo y recurre al generador de filtros.
- El generador toma el evento de la alerta (formado por 400 campos) y la regla que se activó con él, y determina el contexto.
- El generador selecciona los campos relevantes para el filtro.
- El generador normaliza las cadenas.
- El generador forma distintas combinaciones de los campos seleccionados. Para ello, utilizamos el algoritmo FP-Growth (frequent pattern growth) sobre el contexto definido antes. FP-Growth construye, sobre un conjunto de datos (en nuestro caso, el contexto), un árbol de elementos frecuentes (campos) y descarta los que no son lo bastante frecuentes. Esto permite reducir el número de combinaciones que hay que probar y, de este modo, ahorrar recursos en la selección de las más relevantes.
- El generador ordena las combinaciones obtenidas por relevancia y presenta al analista las tres mejores opciones para que elija.
Por ejemplo, veamos un evento descrito por el siguiente JSON:
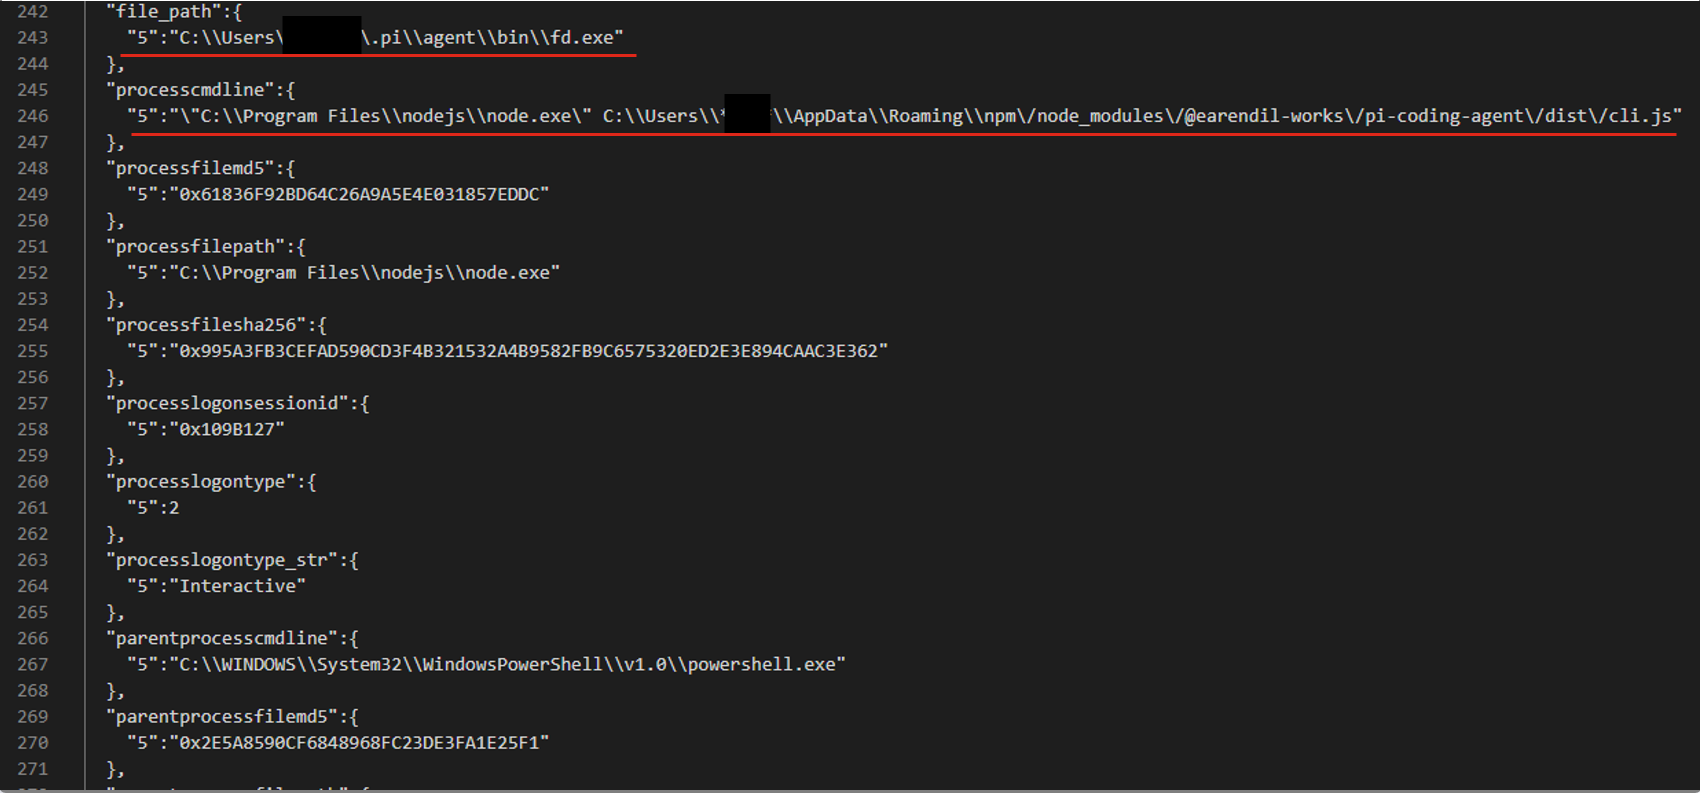
Tras generar las combinaciones y ordenarlas por relevancia, obtuvimos tres filtros que utilizan rutas de archivos:
-
1processcmdline:("nodejs\\node.exe" AND "*****\\appdata\\roaming\\npm\/node_modules\/pi-coding-agent\/dist\/cli.js")
-
1file_path:"*****/.pi\\agent\\bin\\fd.exe"
-
1processcmdline: "programfiles\\nodejs\\node.exe"
El último filtro resultó demasiado amplio, pero el analista marcó los otros dos como válidos.
Ventajas y desventajas del método descrito para la generación de filtros
El método algorítmico para la generación de filtros tiene varias ventajas. En primer lugar, es sencillo y determinista. Es decir, para una misma alerta se obtiene el mismo resultado en cada generación. En segundo lugar, es interpretable: permite entender por qué una combinación concreta quedó entre las mejor valoradas y por qué un campo concreto ni siquiera entró en la lista de campos candidatos. En tercer lugar, las etapas de este proceso son independientes entre sí, por lo que se pueden mejorar y ajustar pasos individuales sin temor a alterar el funcionamiento del algoritmo en otro punto. Por último, no tiene dependencias externas ni modelos, por lo que es fácil de implementar en cualquier entorno del cliente.
Sin embargo, también hay desventajas. La principal es la dependencia del contexto. Si por algún motivo no hay contexto (por ejemplo, cuando es la primera vez que la regla se activa con un evento), no es posible crear el filtro. El segundo problema es la normalización de las cadenas: es muy probable que se encuentren casos atípicos que las reglas de normalización no contemplan y que, con frecuencia, ni siquiera se pueden describir correctamente, porque se contradicen entre sí.
Estos problemas pueden resolverse con modelos de lenguaje grande (LLM). Si los filtros los genera un LLM, no hace falta contexto, porque el LLM no enumera ni ordena combinaciones por relevancia. Además, la red neuronal permite abordar la normalización de las cadenas con más flexibilidad y considerar también casos fuera de los tradicionales. Asimismo, no es obligatorio utilizar el LLM en todas las etapas de la generación. Decidimos conservar la solución algorítmica donde funciona bien. Por ejemplo, un algoritmo sencillo realiza sin errores la etapa de selección de los campos adecuados, por lo que no la trasladamos al modelo.
Generación de filtros con LLM
El proceso de generación de filtros con modelos de lenguaje grandes es el siguiente:
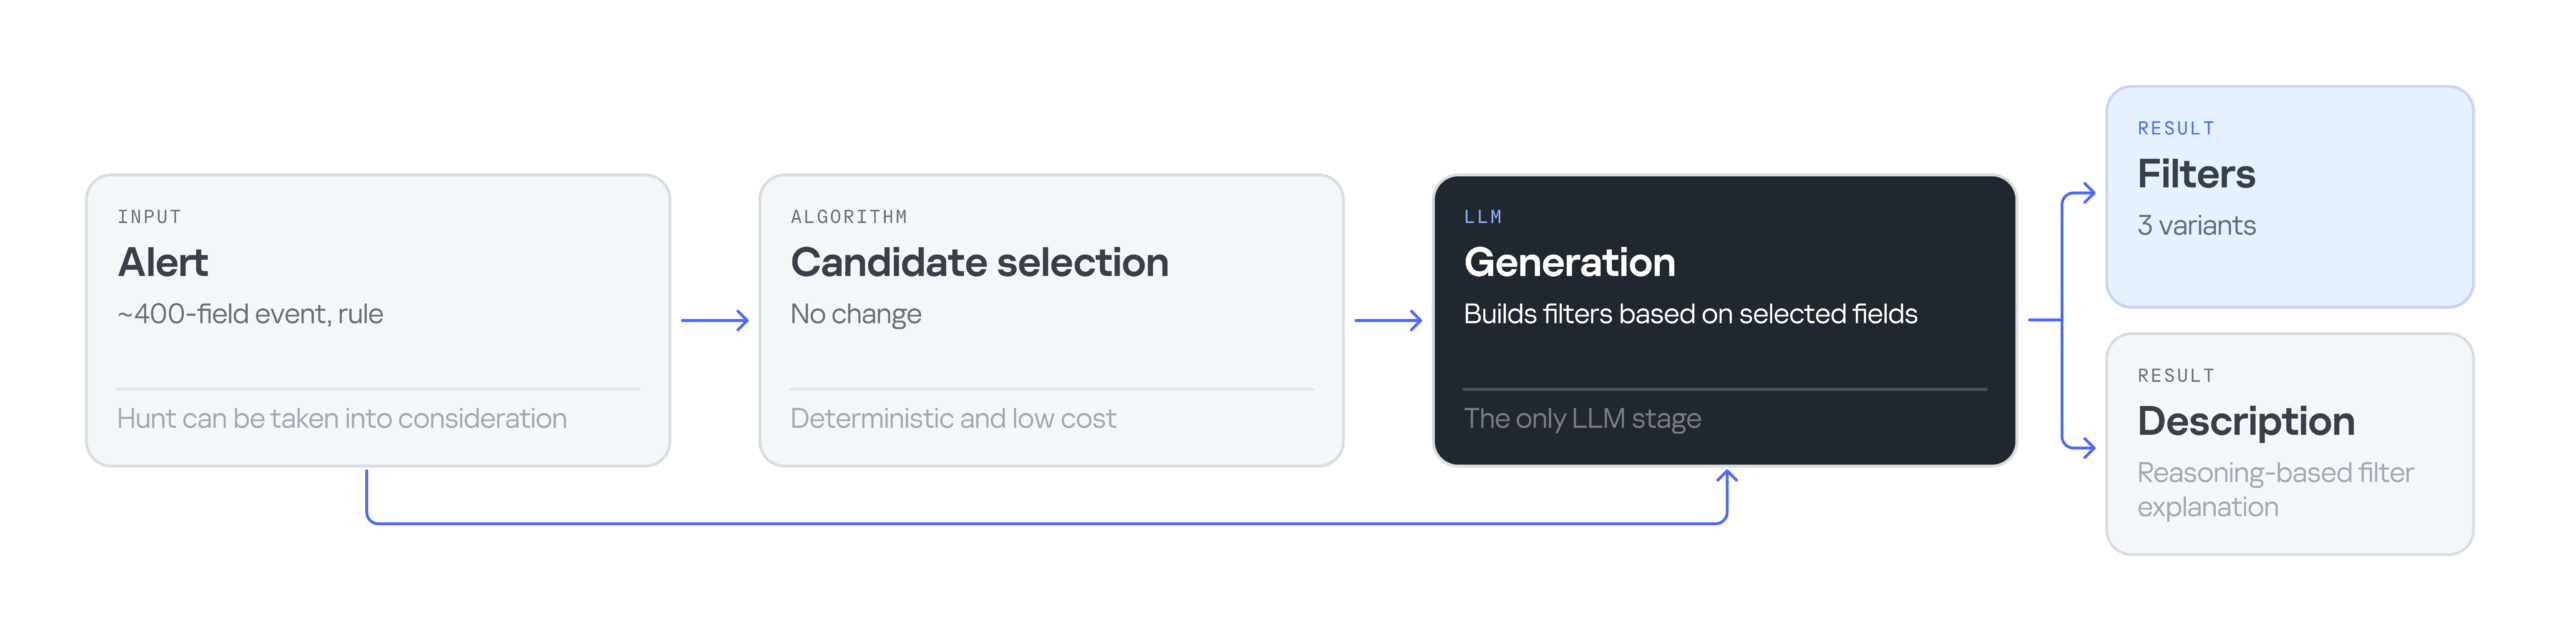
La entrada sigue siendo una alerta que contiene un evento con 400 campos y la regla que se activó con ese evento. A continuación, mediante el algoritmo seleccionamos los campos más adecuados para el filtro. Después, el LLM procesa la información de entrada (el evento, los campos seleccionados y la regla de detección) y genera tres variantes de filtro, junto con una explicación de cada una. La explicación ayuda al analista a entender por qué se proponen esos filtros puntuales, y a tomar una decisión fundamentada.
Veamos el siguiente evento en formato JSON:
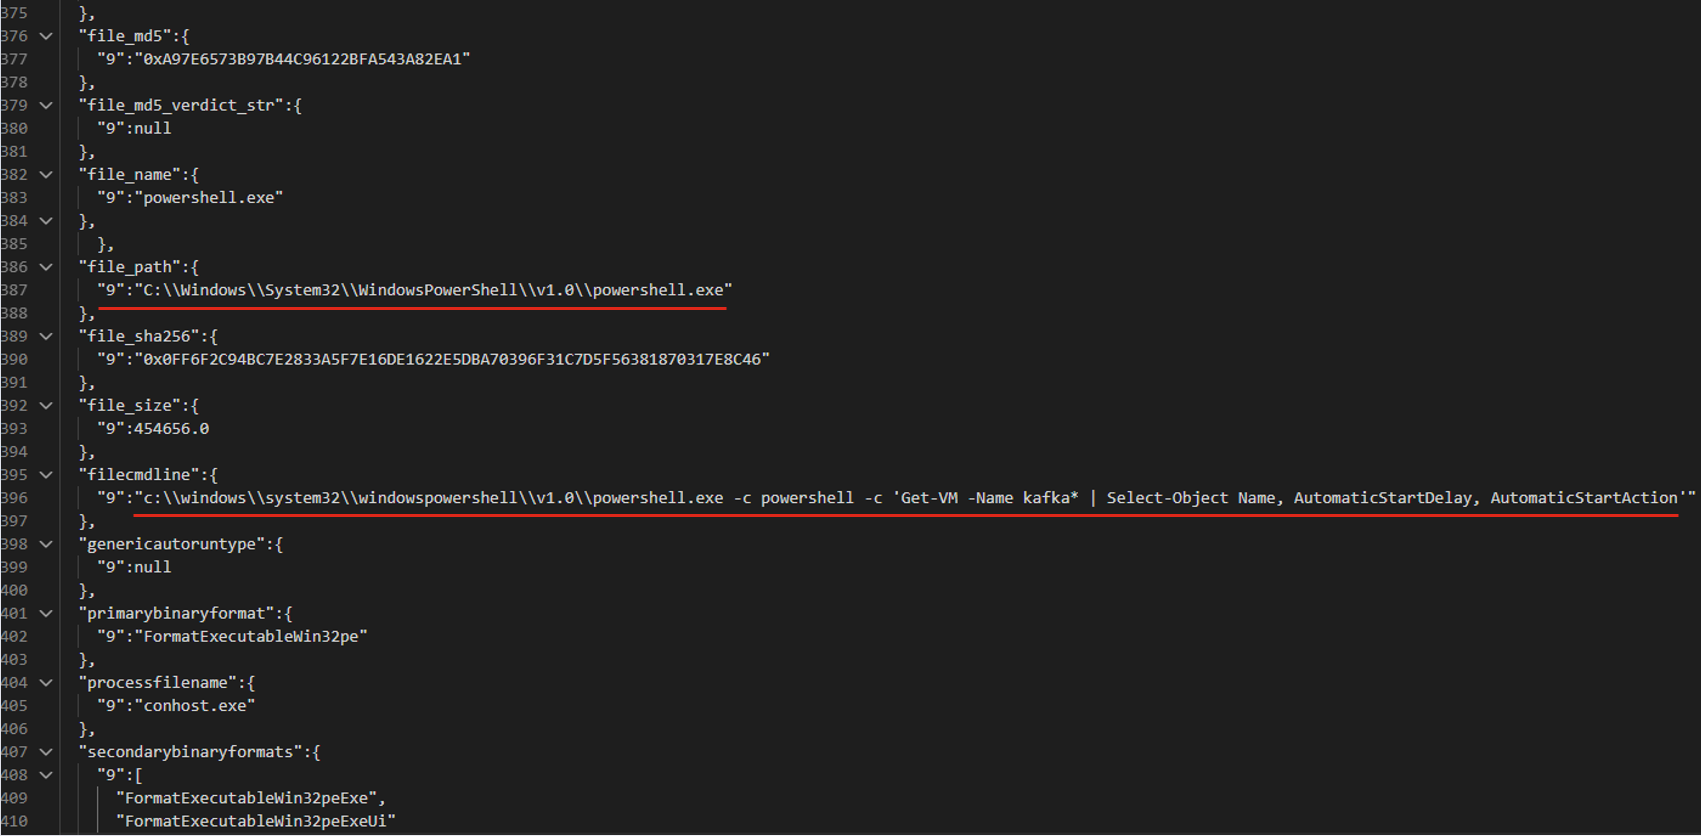
El LLM propuso tres variantes de filtros que contienen una línea de comandos en común:
-
1file_path: "\\WindowsPowerShell\\powershell.exe" AND filecmdline: "Get-VM -Name kafka\*"
-
1filecmdline: "Get-VM -Name kafka\*"
-
1filecmdline: "kafka*"
Igual que en el ejemplo anterior, obtuvimos dos filtros válidos de los tres propuestos. El último resultó demasiado amplio para poder utilizarse. El analista eligió el primer filtro para utilizarlo, tras realizarle pequeñas modificaciones:
|
1 |
file_path: "powershell.exe" AND filecmdline: "Get-VM -Name kafka\*" |
Ventajas y desventajas del método de generación de filtros con LLM
El uso de LLM resolvió los problemas de la generación puramente algorítmica de filtros: la dependencia del contexto y los errores en la normalización de cadenas. Sin embargo, la variante con una sola solicitud al modelo también tenía desventajas. Por un lado, no incluía la validación de los datos de salida. El LLM entregaba los filtros tal cual, sin verificar la sintaxis ni ofrecer la posibilidad de corregir errores. Por otro lado, a diferencia de la versión algorítmica, todas las tareas de generación de filtros se implementaron con un único prompt de sistema. Como consecuencia, una corrección menor en un punto puede alterar la lógica en otro.
Uso de varios agentes de IA
Para resolver los problemas que surgen al usar un solo modelo con un único prompt de sistema para generar filtros, probamos distribuir las distintas tareas entre varios agentes de LLM. En esta versión, incorporamos agentes ya desde la etapa de selección de los campos relevantes. En total, en la cadena participan cuatro agentes:
- Selector: selecciona los campos necesarios
- Generador: genera los filtros
- Validador: evalúa los filtros generados. Si se consideran inválidos, devuelve la tarea al generador. Si los campos seleccionados se consideran irrelevantes, inicia un nuevo ciclo de selección de campos. Si los filtros superan la validación o se agota el límite de intentos de regeneración, los válidos o los más acertados se entregan al analista.
- Comentarista: analiza los filtros generados y explica qué valores de campos se usaron y por qué.
Para el siguiente evento en formato JSON, los agentes generan tres filtros válidos que utilizan la ruta del archivo.
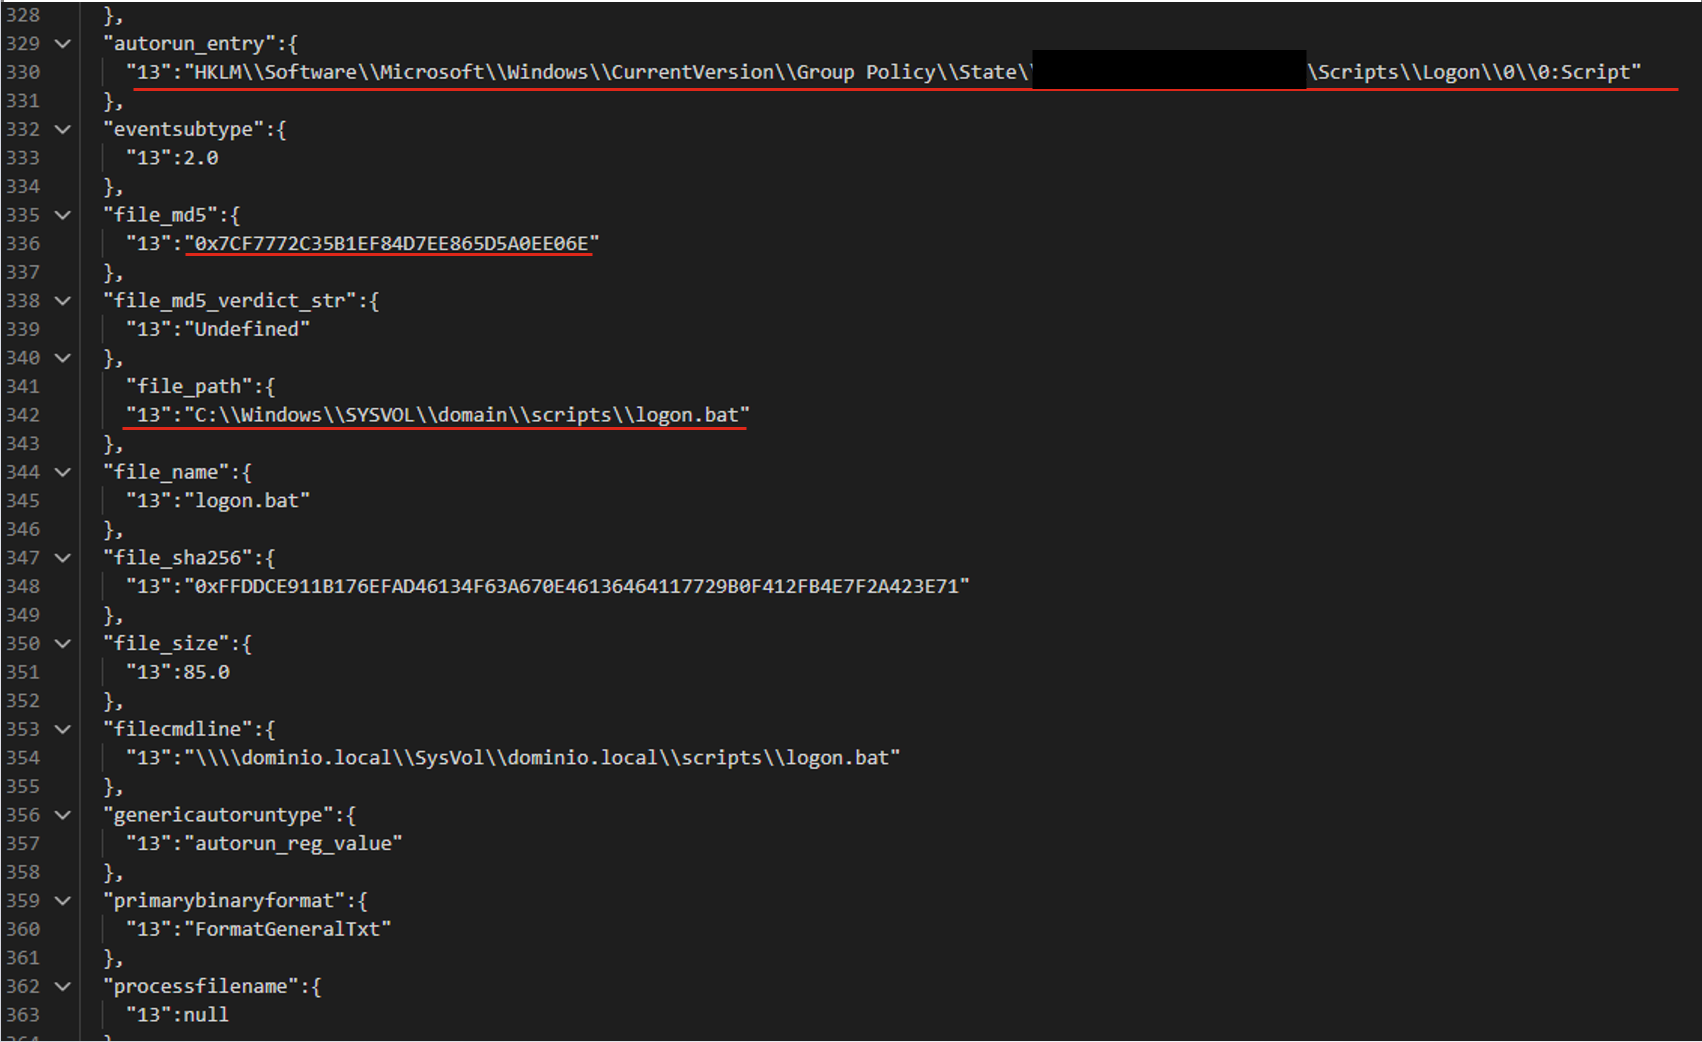
Los filtros se diferencian entre sí por parámetros adicionales que respaldan la detección:
-
1file_path:"sysvol\\domain\\scripts\\logon.bat"
-
1file_path:"sysvol\\domain\\scripts\\logon.bat" AND file_md5:"0x7..6E"
-
1autorun_entry: "Group Policy\\State" AND file_path: "SYSVOL\\domain\\scripts\\logon.bat"
Ventajas y desventajas del método con agentes
Con agentes de LLM obtenemos un sistema que puede validar y corregir los filtros, que además tiene una arquitectura modular y permite ajustar y perfeccionar de forma independiente las distintas etapas de la generación. Por otro lado, el mayor volumen de llamadas al LLM en comparación con los métodos anteriores hace que el sistema sea más lento. Además, depende de la disponibilidad del modelo, que puede no estar presente en el entorno aislado de la organización.
Evaluación del sistema de generación de filtros
Para evaluar la eficacia del sistema de generación de filtros, utilizamos dos métricas principales:
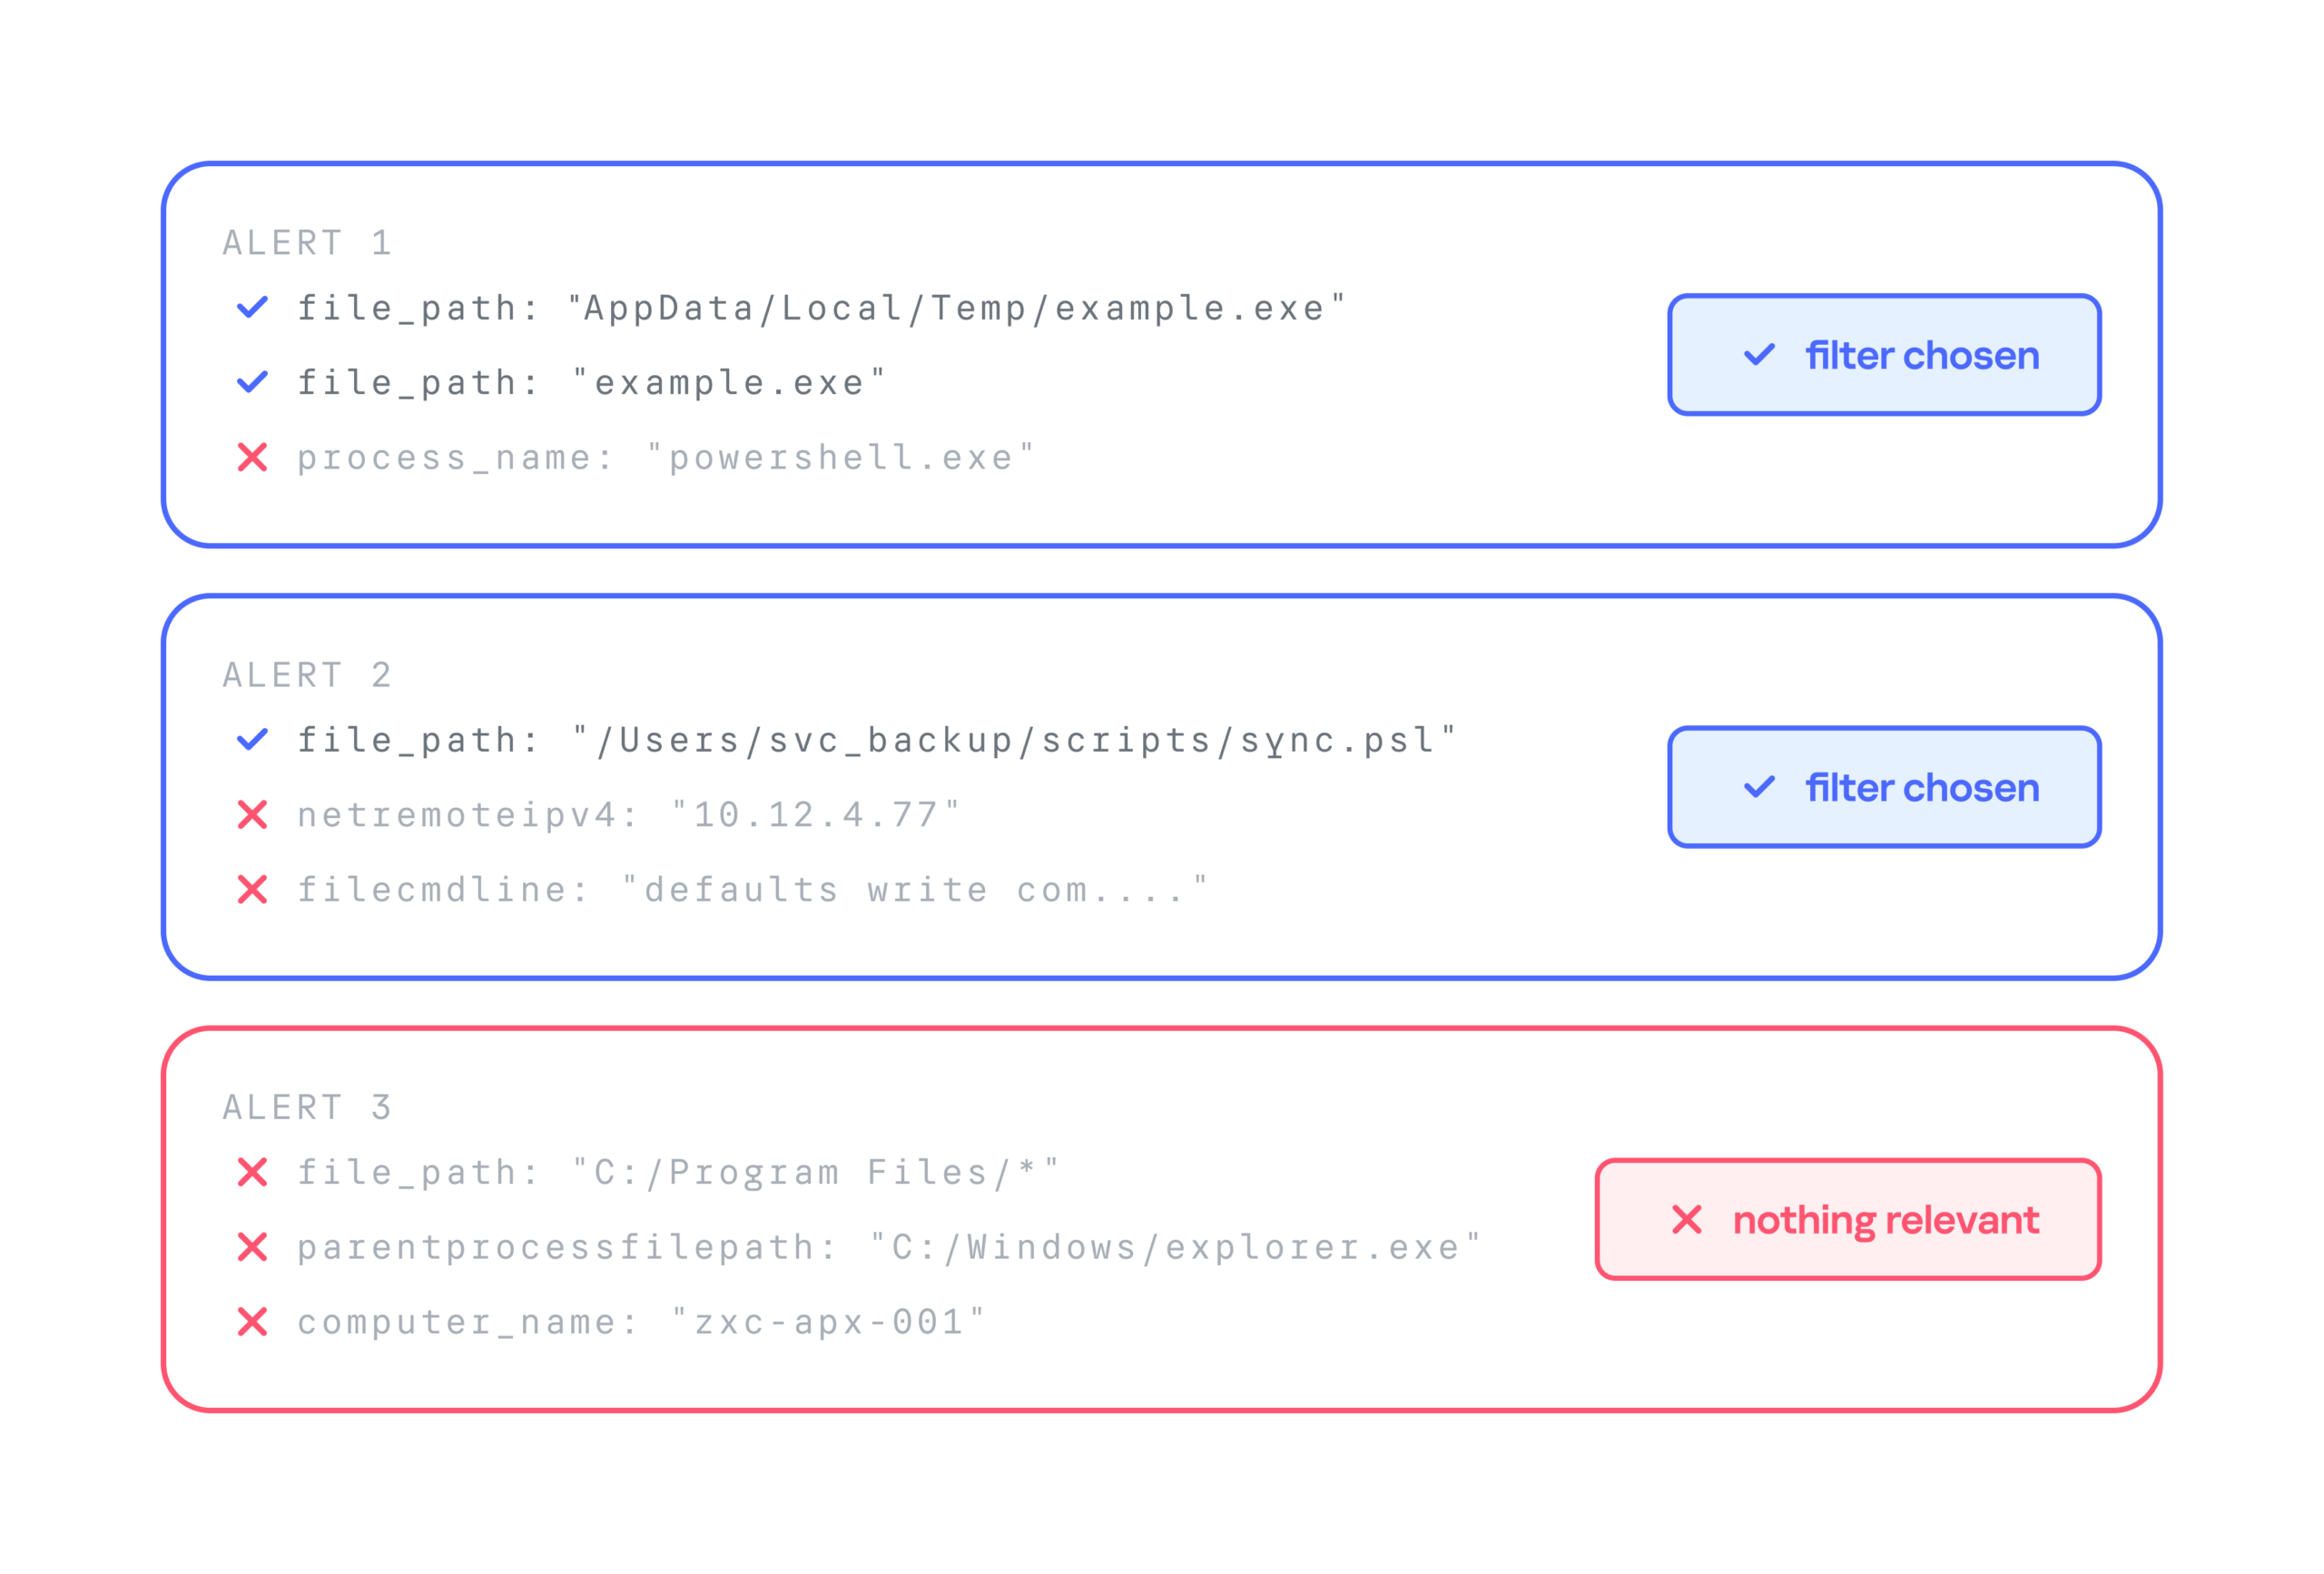
- Tasa de aprobación (Approval Rate). Para cada alerta de seguridad, el sistema propone tres filtros. Si el analista elige al menos uno de ellos, consideramos exitosa la generación. Así, en el ejemplo siguiente, la tasa de aprobación = 2/3.
- Tasa de reducción de falsos positivos (FP drop). Evaluamos en qué medida el filtro ayuda a reducir el número de falsos positivos. Esta métrica solo puede evaluarse con el paso del tiempo, ya que es necesario comparar el número de alertas de falsos positivos recibidas durante cierto periodo antes y después de la implementación del filtro.
A continuación se presenta la evaluación comparativa de los tres sistemas de generación de filtros según estas métricas:
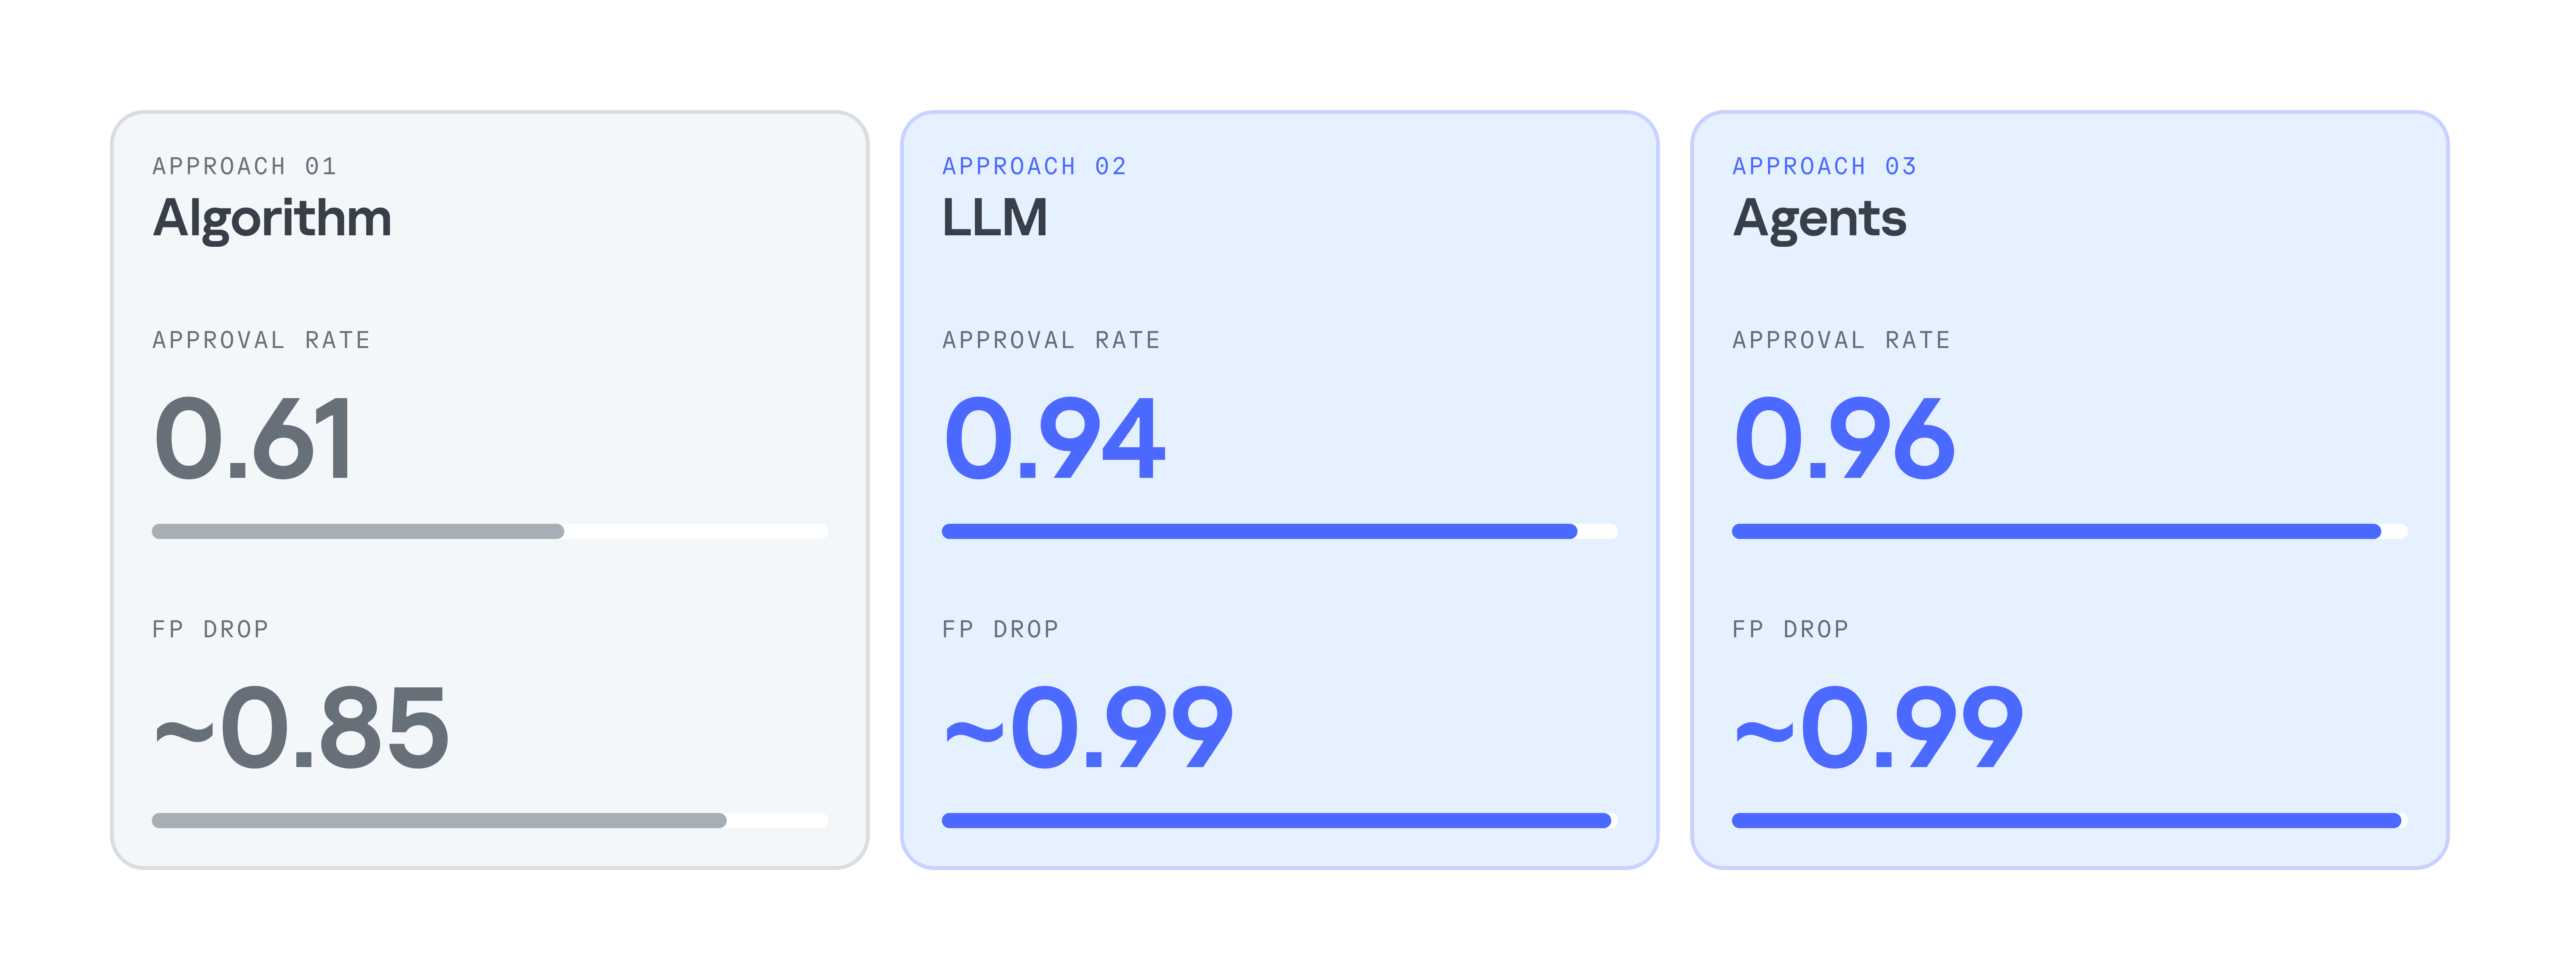
Como se puede ver, los LLM aumentan de forma considerable la eficacia de la generación de filtros. Asimismo, la eficacia de usar un LLM sin agentes y la del método con agentes prácticamente no difieren. Por eso decidimos quedarnos con la opción más sencilla y rápida, que utiliza un LLM con un único prompt de sistema. Como resultado, redujimos en un 99% el número de falsos positivos, aumentamos en un 28% la cantidad de filtros generados por día y mejoramos en un 17% la eficiencia del trabajo de los analistas con las alertas.
Conclusión
Como ha demostrado la práctica, la generación de filtros es una tarea que se presta a una automatización eficaz. Analizamos varias opciones de generación automática de filtros para alertas de seguridad que son falsos positivos, con el uso de un método exclusivamente algorítmico, de un LLM y de un grupo de agentes de LLM. Todas son capaces de generar filtros válidos y simplifican de forma considerable el trabajo del analista, aunque cada una tiene sus propias ventajas y desventajas.
Con el método algorítmico obtuvimos valores más bajos en las métricas de evaluación; sin embargo, en dos tercios de los casos permite obtener filtros que satisfacen al analista. Este método da los mejores resultados cuando ya existe un conjunto de eventos similares que se deben filtrar (es decir, cuando se ha acumulado suficiente contexto). Además, el generador algorítmico se puede implementar en cualquier entorno. Las variantes que utilizan un LLM y un grupo de agentes de LLM muestran un alto nivel de precisión y su efectividad difiere poco; por eso, el método más lento con agentes resulta excesivo por ahora. Si se tiene acceso a un LLM, parece que lo más óptimo es usar un solo modelo para implementar varias etapas del ciclo de generación.

Generación de filtros en la práctica: de los algoritmos a los LLM