
Autores

Nuestro Equipo Global de Respuesta a Emergencias (GERT) ha estado investigando un caso en el que un atacante destruyó el entorno de virtualización de una organización en 10 días. La campaña afectó a cuatro hosts ESXi, a todas las máquinas virtuales (VM) alojadas en ellos, a los dos vCenter Server Appliances y a toda la infraestructura de respaldo conectada. Las notas de rescate identificaban al grupo BlackNevas, observado por primera vez en noviembre de 2024. Lo interesante de este ataque es que no se explotó ninguna vulnerabilidad de la capa de virtualización: no hubo escapes de invitado a host ni corrupción de memoria del hipervisor. Todas las acciones contra ESXi se ejecutaron a través de interfaces de administración legítimas de VMware.
En septiembre de 2021, el código fuente del ransomware Babuk se filtró en línea, incluida su versión para ESXi, poniendo el ransomware para ESXi al alcance de ciberdelincuentes con habilidades técnicas limitadas. Al menos diez familias de ransomware posteriores han aprovechado ese código filtrado, incluidos grupos que, de otro modo, no habrían tenido la experiencia para desarrollar desde cero ransomware compatible con ESXi. Hemos visto a varios operadores usar lockers para ESXi derivados de Babuk junto con las compilaciones de LockBit para Windows que también se filtraron. Cabe señalar que, si bien la versión de Babuk para ESXi puede atacar tanto sistemas antiguos como actualizados, las organizaciones objetivo ejecutaban versiones de ESXi sin soporte, lo que las hace más fáciles de atacar.
Este artículo examina por qué la capa del hipervisor sigue siendo difícil de monitorear, cuáles son las rutas de acceso comunes que usan los atacantes para llegar a ella y cómo establecen persistencia en el plano de administración. También analizaremos la arquitectura de los cifradores para ESXi, la destrucción deliberada de la infraestructura de respaldo y las fuentes de registro que permiten reconstruir los hechos después de un incidente. Al final del artículo, proporcionaremos los indicadores de compromiso recuperados durante la investigación.
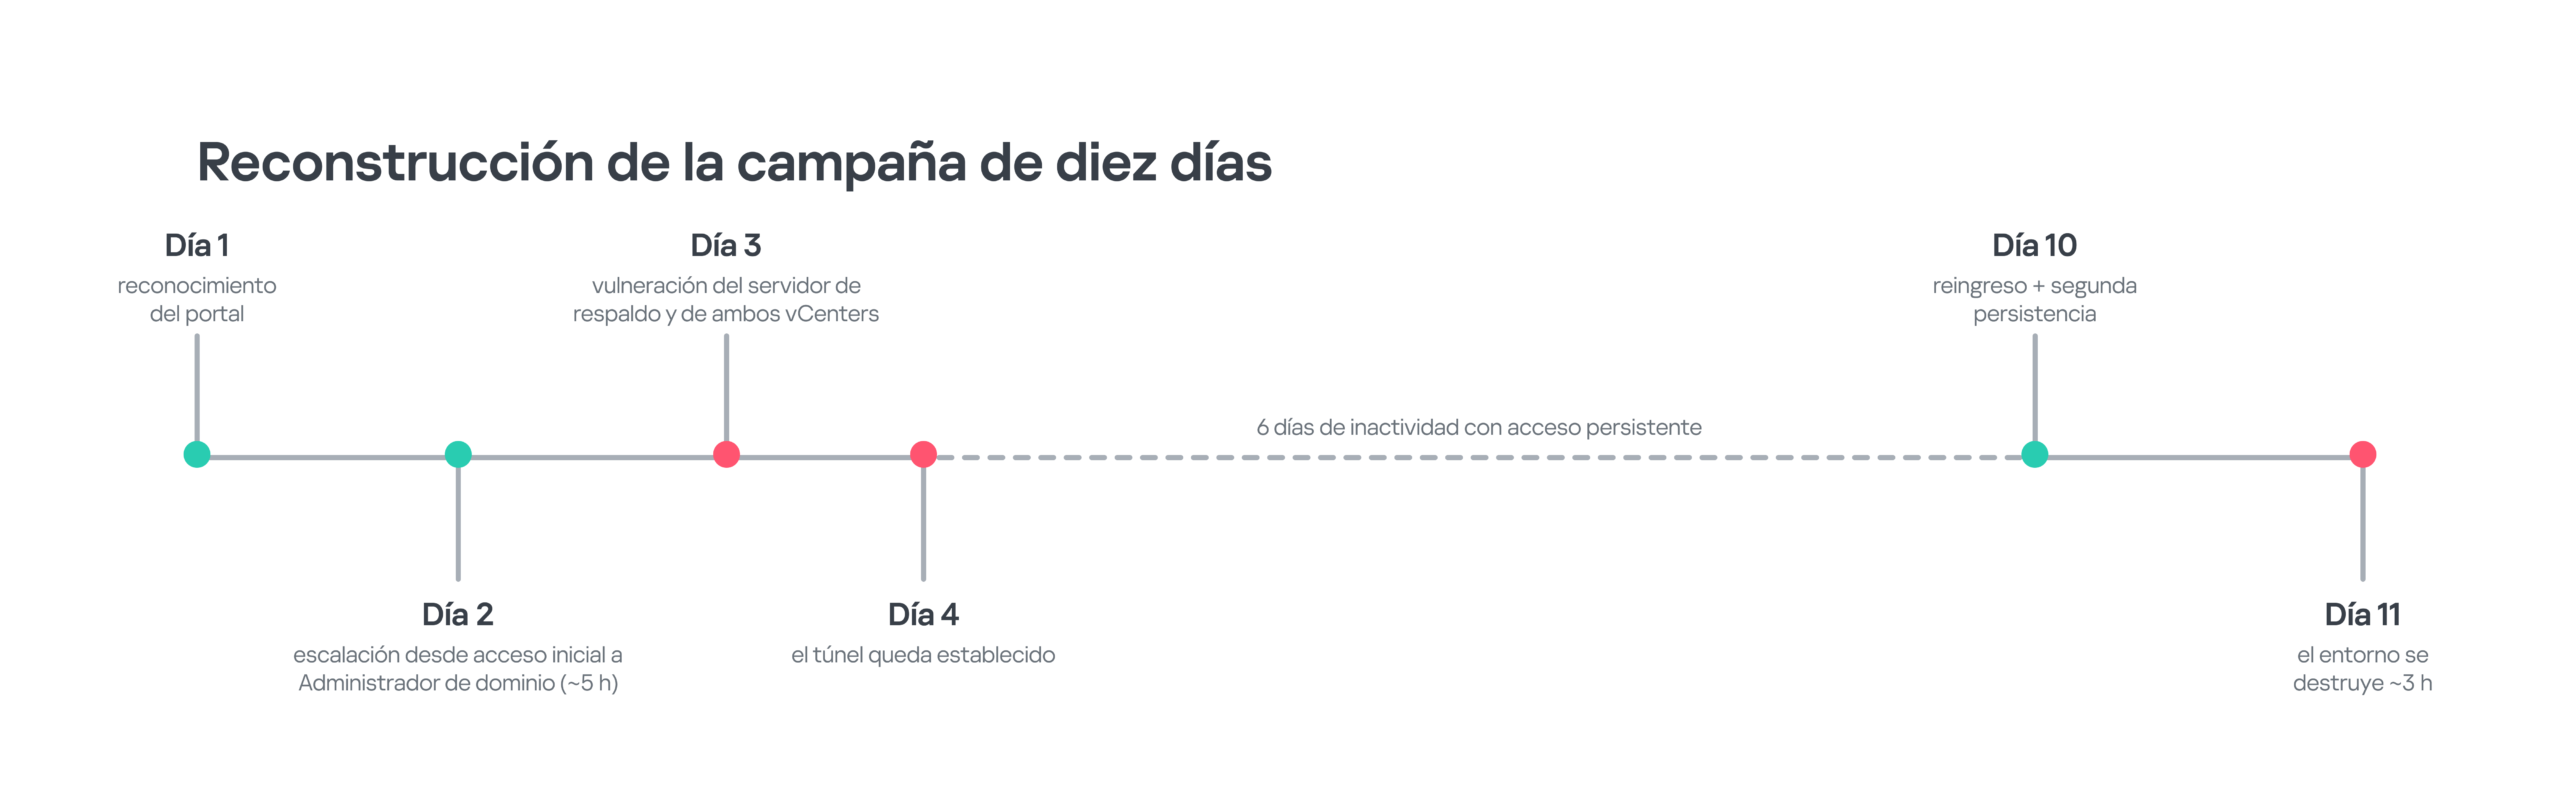
Diez días de tiempo de permanencia desde el acceso inicial hasta la fase destructiva. Cronología reconstruida a partir de las evidencias del incidente
Por qué el hipervisor cambia la economía del ransomware
La virtualización permite una administración de recursos rentable y eficiente, y simplifica las actualizaciones y la aplicación de políticas simultáneas. Sin embargo, también reduce el número de puntos de control y amplía el alcance del impacto en caso de un ciberataque. En entornos no virtualizados, el compromiso de un solo invitado normalmente afecta a un único sistema operativo. El compromiso del plano de administración de la virtualización le da al atacante acceso a muchos hosts de hipervisor, mientras que un impacto directo en un datastore de ESXi puede dejar fuera de servicio muchos sistemas invitados a la vez. Esto convierte a la capa del hipervisor en un objetivo atractivo para los operadores de ransomware, sobre todo cuando los controladores de dominio, los servidores de aplicaciones, las bases de datos y las cargas de trabajo de respaldo comparten el mismo entorno virtualizado.
De acuerdo con el informe global de servicios de ciberseguridad de Kaspersky, el ransomware representó 39.4% de los incidentes que atendió GERT en 2025, y los datos de principios de 2026 muestran que sigue siendo una amenaza importante. En 2023, SentinelOne documentó que varias familias de ransomware utilizan lockers para ESXi derivados del código fuente filtrado de Babuk, lo que redujo la barrera de desarrollo para actores que, de otro modo, carecían de la experiencia necesaria para crear muestras compatibles con ESXi. Esto hizo que el ransomware dirigido a entornos de virtualización fuera más accesible para una gama más amplia de actores de amenazas, y esa tendencia continúa.
La asimetría de visibilidad
ESXi es un hipervisor especializado basado en el VMkernel propietario de VMware. Comparte ciertas similitudes con Linux (y otros sistemas tipo Unix), acepta comandos de Linux y ejecuta cierto software similar al de Linux, pero es diferente de las distribuciones de Linux de propósito general. Broadcom indica que las herramientas de seguridad comerciales diseñadas para sistemas operativos de propósito general no pueden ejecutarse en ESXi de la manera habitual y que no se admite la instalación directa de agentes de terceros ni de antivirus en ESXi y en vCenter Server Appliance (VCSA). Por ello, los defensores dependen en gran medida del fortalecimiento (hardening) integrado, la telemetría del plano de administración, las integraciones de soluciones de seguridad sin agente y la recopilación de telemetría de la infraestructura externa a los hosts ESXi.
Los sistemas operativos invitados suelen estar protegidos por software EDR, pero si un proceso del lado de ESXi modifica un disco de máquina virtual (VMDK) o un archivo relacionado del datastore, un agente EDR dentro del invitado no puede observar ni atribuir de forma directa el proceso del hipervisor que realiza la operación. La telemetría del invitado puede registrar las consecuencias, como errores de E/S o un apagado abrupto, pero la ejecución maliciosa ocurre fuera de sus límites. En el caso analizado aquí, esto hizo que la telemetría nativa del host y del plano de administración fuera fundamental para reconstruir la cronología del incidente.
Cómo llegan los atacantes a la capa de virtualización
Hay distintas rutas de entrada al entorno que requieren controles diferentes, pero que, en última instancia, pueden dar acceso al plano de administración centralizado de la virtualización y a los hosts ESXi que este controla. En este artículo analizaremos cuatro rutas principales que pueden conducir al compromiso de la infraestructura de virtualización:
- Explotación de vulnerabilidades
- Reutilización de credenciales del entorno Windows
- Abuso de la integración con Active Directory
- Infraestructura de respaldo como puente de credenciales
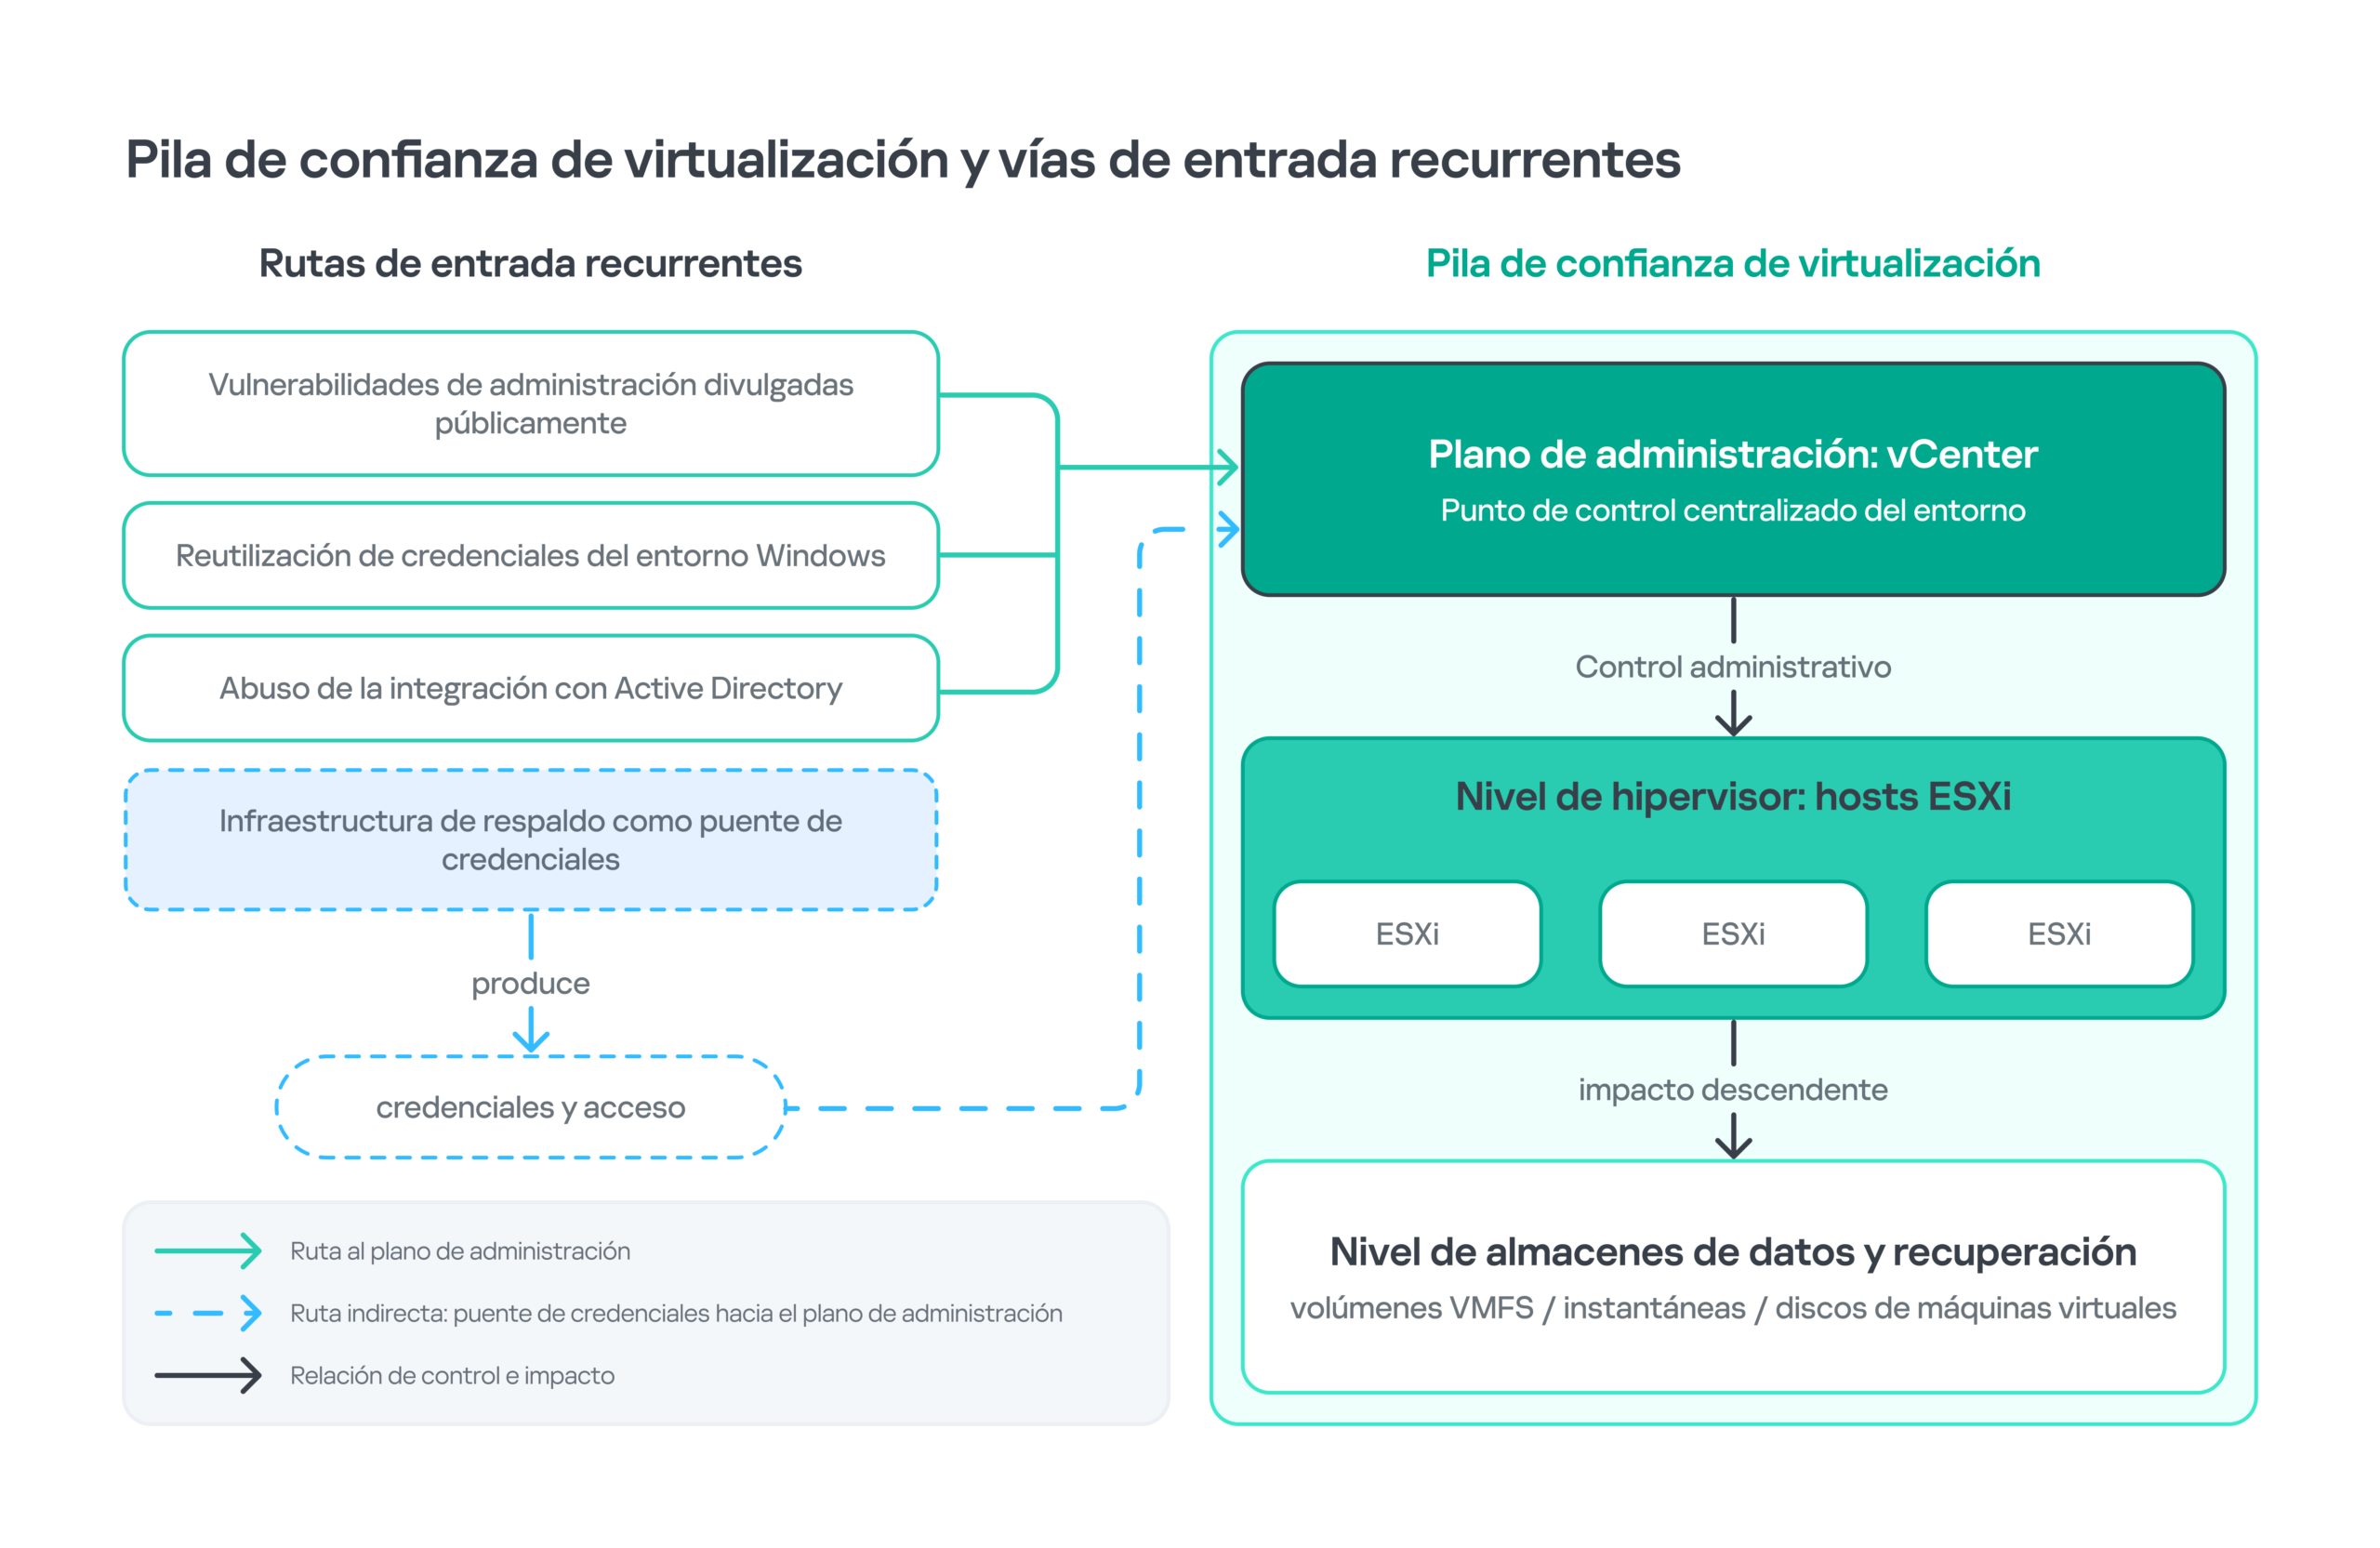
La pila de confianza de la virtualización y las rutas de entrada recurrentes
Explotación de vulnerabilidades
En el incidente que analizamos no hubo evidencia que señalara una vulnerabilidad de ESXi como la ruta de acceso inicial. No obstante, las vulnerabilidades públicas siguen siendo importantes porque se han utilizado para comprometer la infraestructura de administración de la virtualización. Con los exploits disponibles en línea, esta es una de las rutas de entrada más probables. A continuación se presentan varios ejemplos de vulnerabilidades que afectan a entornos de virtualización y que los atacantes han explotado. Por ejemplo, el grupo Twelve encadenó CVE-2021-21972 y CVE-2021-22005 para plantar una web shell directo en un appliance de vCenter, que cargó un backdoor que luego estableció persistencia al inyectar un objeto compartido en el daemon SSH. Cabe señalar que estas vulnerabilidades no están relacionadas con el incidente analizado y se incluyen solo para ilustrar el vector de acceso inicial, lo que puede ayudar a los defensores a definir su superficie de ataque relevante y a priorizar las actividades de aplicación de parches.
| CVE | Capa | Efecto en la seguridad | KEV* | Por qué es relevante aquí |
| CVE-2021-21974 | ESXi OpenSLP | Ejecución remota de código en el servicio OpenSLP vulnerable | No | Históricamente asociada con el ransomware ESXiArgs. |
| CVE-2021-22005 | vCenter Server | Carga arbitraria de archivos que conduce a la ejecución remota de código | Sí | Uso documentado en actividad relacionada con ransomware. |
| CVE-2021-21972 | Complemento de vCenter | RCE sin autenticación mediante el complemento de vSphere Client | Sí | Uso documentado en actividad relacionada con ransomware. |
| CVE-2021-21985 | Complemento VSAN Health Check de vCenter | Ejecución remota de código | Sí | Uso documentado en actividad relacionada con ransomware. |
| CVE-2023-34048 | vCenter DCERPC | Escritura fuera de límites que conduce a RCE | Sí | Vulnerabilidad explotada conocida que afecta a vCenter. Aunque no hay datos sobre su participación en incidentes de ransomware, vale la pena mencionarla por su impacto en el plano de administración de la virtualización. |
| CVE-2024-37085 | Integración de AD en ESXi | Los permisos de AD pueden convertirse en administración total de ESXi | Sí | Uso documentado en actividad relacionada con ransomware. También destaca los riesgos derivados de la relación entre las identidades de AD y el acceso administrativo a ESXi. |
| CVE-2024-38812 / 38813 | vCenter DCERPC | RCE / escalada de privilegios a root | Sí | Vulnerabilidades explotadas conocidas que afectan a vCenter. Aunque no hay datos sobre su participación en incidentes de ransomware, vale la pena mencionarlas por su impacto en el plano de administración de la virtualización. |
| CVE-2025-22224 / 22225 / 22226 | ESXi / Workstation / Fusion | Cadena de invitado a host que requiere privilegios previos en el invitado | Sí | Vulnerabilidades explotadas conocidas que permiten ejecutar una cadena de ataque de invitado a host. Se observó la explotación de CVE-2025-22225 en incidentes de ransomware. Sin embargo, esta cadena de ataque requiere acceso privilegiado a la VM invitada, por lo que es menos crítica que las RCE sin autenticación. |
* Base de datos de vulnerabilidades explotadas conocidas (Known Exploited Vulnerabilities) que mantiene CISA. El estado KEV indica que se ha observado la explotación de una vulnerabilidad en entornos reales, pero por sí solo no indica el uso en ransomware. Cuando se documenta el uso en ransomware, se indica por separado. Ni el estado KEV ni la explotación conocida por parte de actores de ransomware significan que la vulnerabilidad se haya utilizado en el incidente analizado.
Integración con Active Directory
CVE-2024-37085 es una ilustración útil de por qué es fundamental autenticarse por separado en los distintos sistemas, incluso cuando el propio hipervisor tiene los parches aplicados. La vulnerabilidad afecta a los hosts ESXi configurados para usar AD en la administración de usuarios. Según Microsoft, los operadores de ransomware la explotan, entre ellos Akira y Black Basta, abusando del comportamiento del grupo ESX Admins para obtener la administración total de ESXi. CISA incluye el problema en su catálogo KEV y señala que se ha utilizado en incidentes de ransomware.
La vulnerabilidad se corrige en ESXi 8.0 U3. Para los sistemas más antiguos, Broadcom recomienda la siguiente solución alternativa:
- cambiar el valor de
esxAdminsGroupAutoAdddetrueafalse, - cambiar
authValidateIntervalde 1440 a 90 minutos, - borrar la asignación predeterminada del grupo ESX Admins cuando corresponda.
Estos controles reducen la exposición, pero la lección arquitectónica es más amplia: que el dominio esté comprometido no debería ser suficiente para que el adversario obtenga derechos de administrador del hipervisor.
Recomendación para los defensores
Recomendamos evitar la dependencia directa e innecesaria de Active Directory en los hosts ESXi. Cuando los requisitos del negocio lo exijan, conviene aplicar el principio de mínimo privilegio: agregar a los grupos administrativos solo las cuentas que realmente necesiten ese nivel de acceso, usar cuentas de administrador y credenciales independientes para el dominio y para los hipervisores, restringir el acceso a las interfaces de administración de ESXi y vCenter solo a los segmentos de red, las cuentas y las estaciones de trabajo necesarios para controlarlos, y validar con frecuencia los cambios de permisos de ESXi. El control de acceso basado en roles (RBAC) de vCenter y la federación de identidades deben configurarse para la administración de la virtualización, mientras que las credenciales empresariales ordinarias y los grupos de dominio amplios no deben usarse para acceder a vCenter ni a ESXi con privilegios elevados.
Reutilización de credenciales del entorno Windows
La tercera ruta no requiere ninguna vulnerabilidad. Las credenciales administrativas presentes en controladores de dominio, jump servers, sistemas de respaldo, infraestructura de identidad o estaciones de trabajo de administradores pueden dar acceso a vCenter o ESXi si se usan las mismas cuentas de administrador en distintos segmentos de la infraestructura. MITRE ATT&CK considera que la técnica Valid Accounts es aplicable a ESXi y señala que las cuentas predeterminadas o de dominio comprometidas pueden proporcionar acceso privilegiado a otros sistemas.
En el incidente analizado, se usaron credenciales obtenidas de sistemas ajenos a la virtualización dentro del perímetro de la organización para llegar a los vCenter Server Appliances. A diferencia de la explotación de vulnerabilidades, una autenticación exitosa con una cuenta válida puede parecer operativamente normal. Por lo tanto, para detectar de forma confiable esta actividad, los analistas deben evaluar el host de origen, el historial de la cuenta, la hora, el destino, las acciones administrativas posteriores y si la cuenta autenticada administra normalmente la infraestructura de virtualización.
Infraestructura de respaldo como puente de credenciales
Las plataformas de respaldo no son un almacenamiento pasivo. Suelen requerir cuentas de servicio, credenciales del hipervisor, acceso a repositorios y un amplio alcance de red para poder proteger y restaurar cargas de trabajo críticas. Esto convierte al servidor de respaldo en un punto de confianza concentrado. En el incidente analizado, el adversario extrajo credenciales almacenadas tras obtener ejecución administrativa en la infraestructura de respaldo, lo que creó una ruta hacia otros niveles de la infraestructura.
Persistencia en el plano de administración
Una vez explicados los posibles riesgos, volvamos a nuestro caso de estudio. Los atacantes lograron comprometer mediante SSH el appliance de vCenter que administraba la recuperación ante desastres de la virtualización, donde establecieron dos capas de persistencia. La primera utilizó MeshAgent, el componente de endpoint de la plataforma legítima de administración remota MeshCentral. La segunda utilizó Ligolo-ng como túnel inverso, implementado como un servicio de systemd. Esta actividad corresponde a dos técnicas de ATT&CK: Systemd Service (T1543.002) y Protocol Tunneling (T1572).
La cronología fue la siguiente. Los atacantes se autenticaron en el appliance como root mediante SSH. Cuarenta y tres segundos después, descargaron e implementaron MeshAgent mediante un script de shell. La sesión SSH duró 2 minutos y 26 segundos en total. Al finalizar, el adversario no volvió a usar SSH para acceder al appliance comprometido, lo que reduce la utilidad de un monitoreo centrado en sesiones SSH interactivas. Alrededor de cuatro horas después, regresaron a través de MeshAgent e instalaron el túnel Ligolo-ng como una unidad persistente de systemd.
|
1 2 3 4 5 6 7 8 9 |
Unit file /etc/systemd/system/vmware-vdma.service Service vmware-vdma Description "DNS, time, VM settings sync (v2.03.24766)" ExecStart /opt/vmware/bin/agent Restart always Strings in /opt/vmware/bin/agent: Ligolo-ng v0.8.2 api.cloudvflare[.]com:443 |
La unidad usa un prefijo similar al de VMware, coloca su binario en /opt/vmware/bin/, describe funciones factibles de mantenimiento del appliance y establece Restart=always. Un defensor no debe tratar como malicioso por defecto a cualquier servicio no reconocido con apariencia de VMware, porque pueden existir integraciones personalizadas, pero un servicio fuera de la lista de servicios que la organización define como confiables es una anomalía de alta confianza que requiere verificación inmediata.
Además del incidente analizado, se han documentado técnicas de persistencia en ESXi más avanzadas. Por ejemplo, Mandiant observó a atacantes que usaban vSphere Installation Bundles (VIB) maliciosos como mecanismo de persistencia en hosts ESXi comprometidos. Esto demuestra que los atacantes con acceso administrativo pueden establecer acceso persistente en la capa del hipervisor, incluida una persistencia que sobrevive a los reinicios del host. Sin embargo, el incidente analizado muestra que un software común de administración remota y un servicio de systemd pueden ser suficientes cuando se confía en el propio vCenter y este está mal monitoreado.
Convertir vCenter en un plano de control ofensivo
Una técnica interesante observada en el incidente fue el uso de los Host Profiles de vCenter. Los Host Profiles están diseñados para capturar y aplicar la configuración en los hosts ESXi. Un Host Profile puede aplicarse a hosts individuales, a clústeres de hosts o a todos los hosts asociados con un perfil. También puede contener subperfiles que abarcan aspectos específicos de la configuración, como la autenticación. Entre otras cosas, los Host Profiles pueden contener la configuración de Tech Support Mode (TSM) y TSM-SSH.
En el incidente analizado, el adversario usó Host Profiles para cambiar el estado del servicio TSM-SSH y habilitar SSH en los hosts ESXi objetivo. Las evidencias registraron la siguiente secuencia:
| Tiempo | Origen | Evento observado | Evidencia principal |
| T+0 | vCenter | Configuración del host leída mediante el flujo de trabajo de Host Profile | vpxa.log |
| T+10m18s | vCenter | Cambio de configuración enviado para habilitar SSH | vpxa.log |
| T+10m51s | vCenter / ESXi | El servicio TSM-SSH alcanzó el estado RUNNING, lo que indica que SSH se habilitó en el host y que es accesible desde un dispositivo remoto |
vpxa.log + vobd.log |
Cabe señalar que el intervalo de 33 segundos entre el envío de la configuración y el momento en que TSM-SSH alcanzó el estado RUNNING es lo bastante corto como para correlacionar rápidamente estos eventos, comparando registros de distintas fuentes. En total, el atacante tardó once minutos desde la lectura inicial de la configuración en reconfigurar el host de SSH deshabilitado por política a un acceso remoto directo. Después, se produjo un acceso SSH directo a los hosts ESXi objetivo desde la IP del appliance de vCenter, un origen que en general se consideraría de alta confianza en la red de administración.
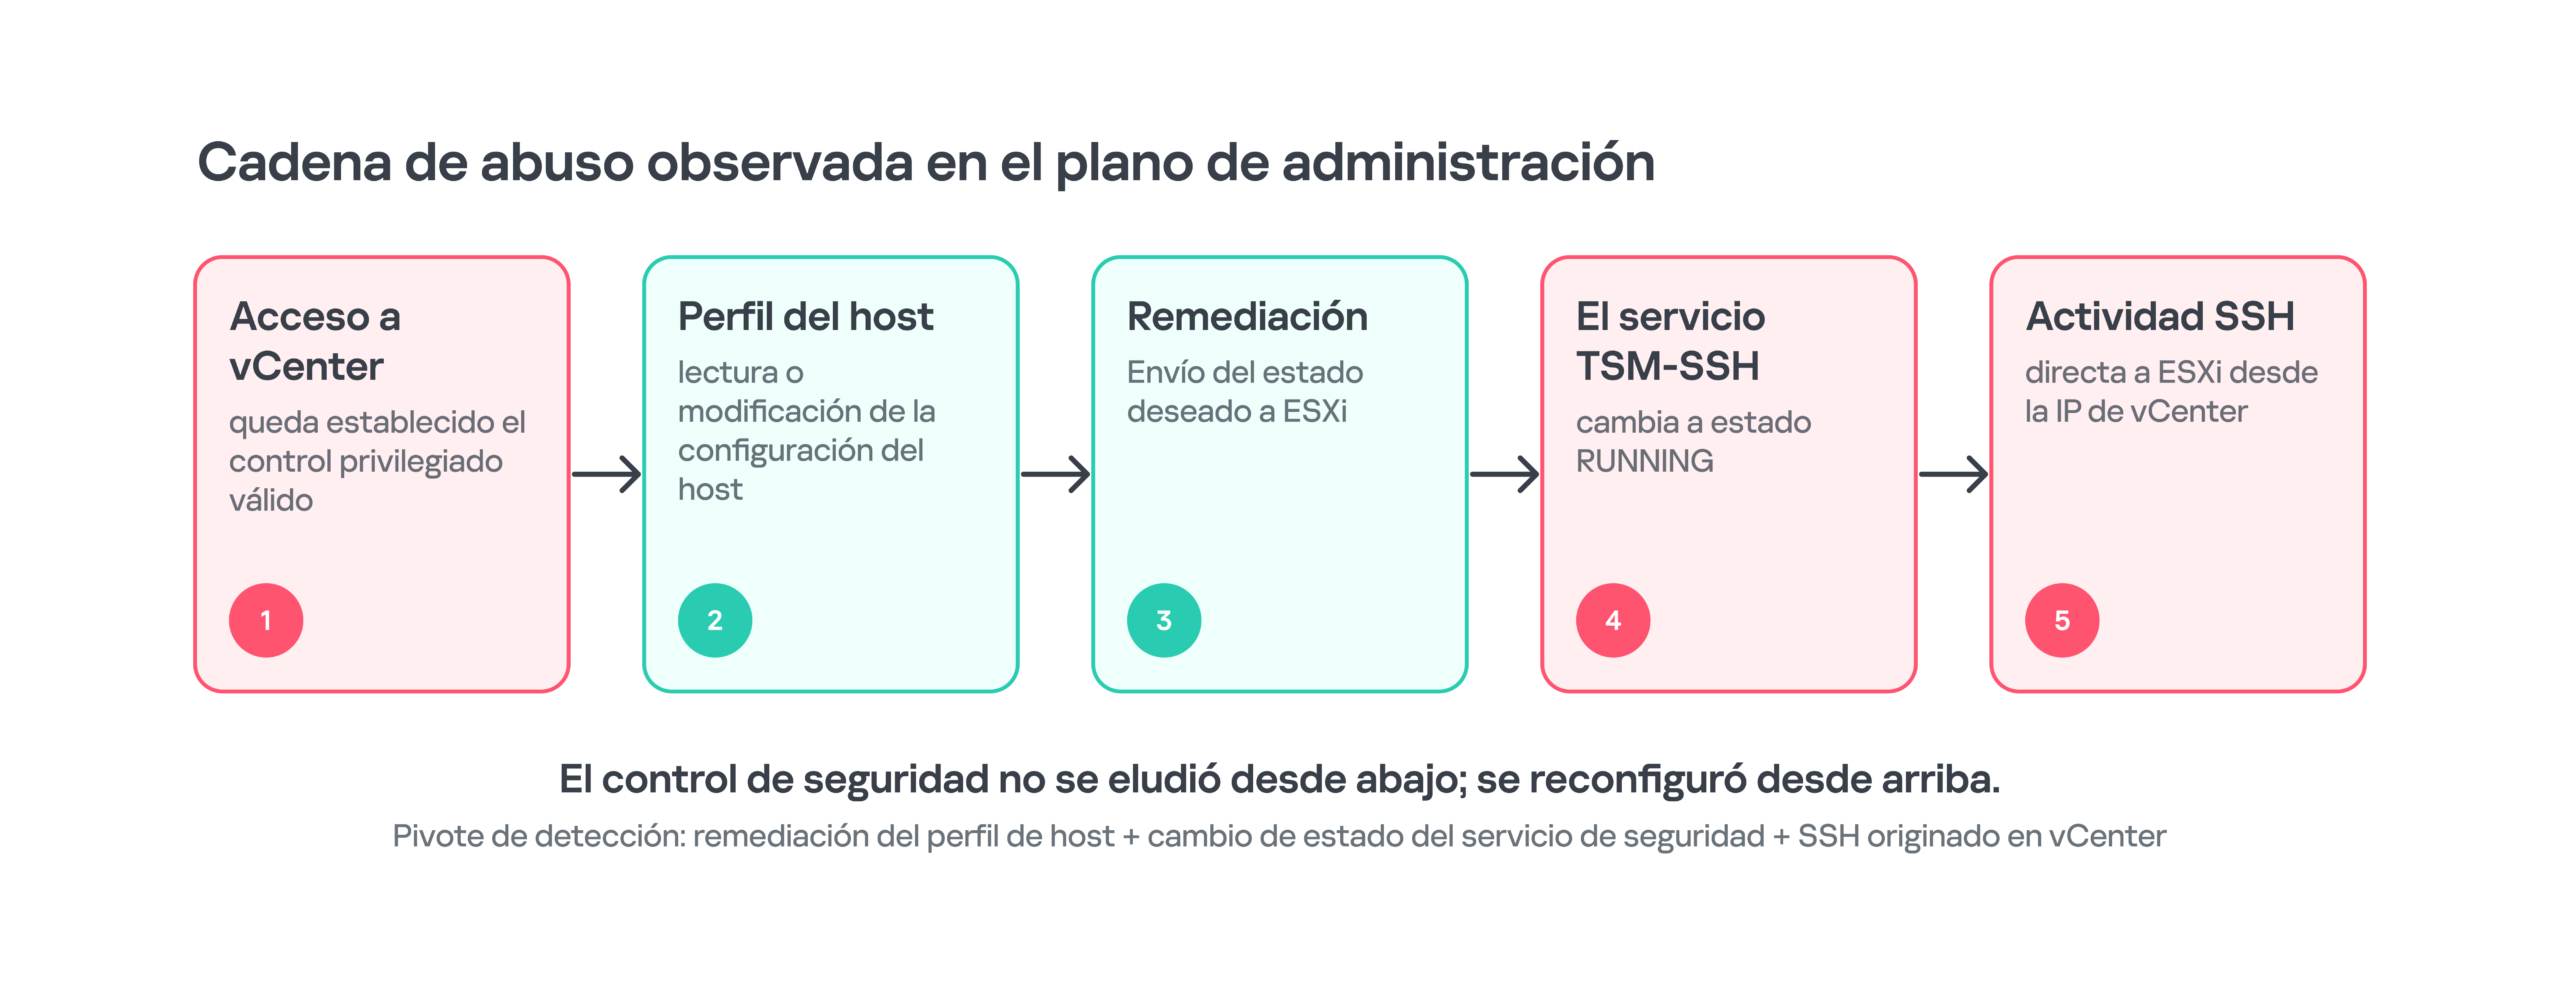
El compromiso del plano de administración convirtió un mecanismo legítimo de cumplimiento en una ruta de acceso al hipervisor administrado
Por qué un cambio de configuración de ESXi mediante vCenter es una falla del límite de confianza
El fortalecimiento de los hosts es importante, pero los controles administrados de forma centralizada no deben considerarse independientes una vez que la herramienta central de administración está comprometida. Si vCenter tiene autoridad para modificar el estado de los hosts, un atacante que lo controle puede lograr que un cambio malicioso parezca estructuralmente similar a una actividad legítima de cumplimiento: leer la configuración, aplicar el estado deseado, observar el resultado. Para determinar si se trata de una actividad legítima o maliciosa, es necesario tener en cuenta factores como la autorización, el momento en que se realiza la acción, la cuenta de origen, el periodo autorizado para realizar cambios y si el estado deseado reduce el nivel de seguridad.
Por eso vCenter debe tratarse como un activo de Tier 0 y contar con el máximo nivel de protección posible. Las cuentas administrativas del plano de administración deben aislarse de la administración empresarial ordinaria, el acceso de red debe restringirse a rutas de administración dedicadas, los cambios de configuración de alto riesgo deben exigir autenticación fuerte y monitoreo, y el tráfico de vCenter a ESXi debe compararse minuciosamente con una línea base de comportamiento normal (patrones de conexión, puertos, protocolos, sistemas de origen y destino) en lugar de gozar de confianza implícita. Todas las discrepancias significativas deben tratarse como sospechosas e investigarse.
Oportunidad de detección de alta fidelidad
Debe generarse una alerta cuando el cumplimiento (o la remediación, en la terminología de VMware) de un Host Profile cambie la configuración de TSM o TSM-SSH fuera del periodo autorizado, en particular si, a continuación, se inicia una nueva sesión SSH desde vCenter u otro appliance de administración. Esta secuencia es más precisa que alertar solo por SSH, porque cada paso es legítimo de forma aislada, pero peligroso en combinación.
Notas sobre el abuso de ESXi: herramientas living-off-the-land y controles que se deben monitorear
Una vez que un atacante puede administrar ESXi, muchas acciones destructivas no necesitan ningún exploit. El proyecto LOLESXi cataloga los binarios y scripts nativos de ESXi de los que han abusado los actores de amenazas, incluidas utilidades administrativas que enumeran VM, controlan el estado de encendido y alteran la configuración. Esto refleja el comportamiento living-off-the-land en Windows, pero el objetivo es el plano de control del hipervisor.
Hay dos mecanismos de fortalecimiento de ESXi cuya modificación puede levantar muchas sospechas. El nivel de aceptación del host controla qué VIB se pueden instalar. El ajuste execInstalledOnly controla si pueden ejecutarse binarios no instalados. Broadcom indica que ESXi 8 habilita de forma predeterminada la opción de runtime execInstalledOnly y advierte que deshabilitarla permite la ejecución de binarios desconocidos no instalados, lo que aumenta el riesgo de ransomware. También existe un ajuste de aplicación a nivel de kernel con el mismo nombre, que está relacionado con la opción de runtime, pero es distinto. Sus cambios pueden requerir un reinicio.
| Control | Qué regula | Por qué un cambio es sospechoso | Evidencia útil |
| Nivel de aceptación del host | Qué paquetes VIB se pueden instalar | Reducirlo a un nivel menos confiable amplía lo que el host aceptará | esxcli / eventos de configuración / esxupdate.log |
execInstalledOnly en runtime |
Ejecución de binarios no instalados mediante paquetes VIB | El valor 0/FALSE permite la ejecución de código no instalado |
vobd.log + ajustes avanzados |
Aplicación de execInstalledOnly en el kernel |
Aplicación más estricta a nivel de arranque de VMkernel que restringe la ejecución a archivos que fueron instalados mediante paquetes VIB y que después no fueron modificados. | Debilitarlo puede requerir un reinicio y modifica la línea base de seguridad | ajustes del kernel + historial de arranque |
Dentro de la fase de impacto en ESXi
Detención de las VM antes del impacto
Los lockers maduros para ESXi suelen detener las máquinas invitadas antes de modificar los datos de los discos virtuales, porque las VM en ejecución mantienen un estado activo y bloqueos de archivos. Cada familia lo implementa de forma distinta, lo que genera detecciones conductuales útiles. Las familias que se describen a continuación no están relacionadas con el incidente que analizamos, pero estas descripciones pueden ser útiles para la protección contra ransomware en general.
| Familia de ransomware | Método de detención de VM observado o documentado |
| GwisinLocker, LockBit, Conti | Enumeran los worlds (contextos de ejecución de ESXi) con el comando esxcli vm process list y finalizan worlds individuales con el comando esxcli vm process kill. |
| AvosLocker, RedAlert (aka N13V) | Usan un único pipeline de shell para enumerar los worlds y forzar su detención. |
| Hive, fcker.py | Usan vim-cmd vmsvc/power.off para las VM registradas. |
| Compilaciones de RansomHub para ESXi | Contienen lógica personalizada en C++ que puede enumerar y detener máquinas sin depender de la secuencia de comandos de esxcli o vim-cmd. |
No conocemos la técnica exacta utilizada para detener las VM en el incidente analizado. Sin embargo, una secuencia rápida de operaciones de apagado o de detención forzada de worlds en muchas VM es siempre una señal de alta confianza previa al impacto. En las evidencias del caso analizado, el host de recuperación ante desastres mostró que todas las VM se detuvieron en un lapso de 23 segundos, mientras que vmksummary.log, que almacena el número de VM en ejecución cada hora, mostró que este descendía de los valores normales a cero.
Entrega del payload y comportamiento de FlowSsh
El payload se entregó a ESXi mediante SFTP. El archivo de registro de autenticación auth.log expuso un identificador de cliente asociado con FlowSsh, la biblioteca de cliente SSH de Bitvise para C, C++ y .NET. FlowSsh admite SFTP, solicitudes de ejecución remota, sesiones de shell interactivas y tunelización. Esas capacidades concuerdan con el modelo de entrega observado, pero la identificación de la biblioteca debe basarse principalmente en el identificador de cliente registrado y no solo en una inferencia conductual.
Después de la entrega del payload, se ejecutó la siguiente serie de comandos. Reconstruimos esta secuencia principalmente a partir del archivo de registro shell.log.
| Tiempo | Comando observado | Nota analítica |
| T+0 | true | Sondeo sin operación (no-op) en una sesión dedicada. |
| T+1s | chmod +x /tmp/esx64 | Sesión de ejecución independiente. |
| T+1m48s | true | Segundo sondeo sin operación (no-op). |
| T+1m49s | ./tmp/esx64 /selftest | Sesión de ejecución independiente; etapa de validación del payload. |
Cada par de comandos fue precedido por una sesión que ejecutaba únicamente true. Este patrón repetitivo es coherente con la configuración automatizada de canales de FlowSsh, pero por sí solo no puede considerarse un indicador confiable de la herramienta utilizada. Los operadores humanos también podrían haber escrito true, y otros frameworks de automatización podrían haber emitido sondeos de accesibilidad. Por lo tanto, la secuencia debe rastrearse como una huella de comportamiento, no tratarse como una firma única de FlowSsh. Su valor aumenta cuando se combina con un identificador de cliente SSH inusual, el staging mediante SFTP en /tmp, chmod y una posterior autoprueba o ejecución del payload.
La ventana de tres horas de la autoprueba
La ejecución de /selftest duró aproximadamente 16 segundos y ocurrió unas tres horas antes de la detonación final. Una ejecución de prueba previa al impacto puede sugerir que el operador estaba validando la compatibilidad con la compilación de ESXi objetivo antes de pasar a la ejecución destructiva.
Oportunidad de detección previa al impacto
Recomendamos tratar como una secuencia crítica previa al impacto la preparación (staging) inesperada de un ejecutable en /tmp, seguida de su ejecución y de un acceso posterior a /vmfs. Aunque indicadores individuales como chmod +x pueden ser ambiguos de forma aislada, la ejecución inesperada de un ejecutable recién preparado desde /tmp puede ser por sí misma un fuerte indicador de actividad maliciosa. La secuencia completa aporta evidencia contextual más sólida al vincular la preparación del payload, su ejecución, su validación y el acceso posterior a la capa de almacenamiento de las VM.
Comando de detonación y confianza de la evidencia
Los atacantes ejecutaron el siguiente comando para desencadenar la actividad destructiva.
|
1 |
./tmp/esx64 /p /vmfs/ /depth 5 /wipe /allsys /detach /-showvolumes |
Desglosemos el comando en parámetros individuales y analicemos su utilidad forense. La interpretación de cada parámetro incluye un nivel de confianza, porque los detalles exactos de la implementación no pueden reconstruirse sin el binario.
| Parámetro | Significado observado o corroborado | Confianza de la interpretación |
| /p /vmfs/ | La ruta de destino es la raíz de VMFS, donde residen los archivos de las VM. | Alta: comando directo + ruta de la plataforma. |
| /depth 5 | Profundidad de la recursión de directorios. | Alta: significado convencional del argumento y posición observada. |
| /wipe | Comportamiento de sobrescritura/borrado; se encontraron artefactos ._wipe en los distintos datastores. | Alta para el comportamiento destructivo, media para la implementación exacta. |
| /allsys | Incluir archivos del sistema. Esto coincide con el comportamiento documentado públicamente de la familia BlackNevas/Trigona. | Media: la evaluación se basa en la comparación con el comportamiento documentado públicamente de la familia de malware; la falta del binario impide la validación directa. |
| /detach | Desvincular de la terminal; la actividad continuó tras la desconexión de SSH. | Alta: documentación externa + persistencia de los efectos en el incidente. |
| /-showvolumes | Suprimir el listado de volúmenes según los parámetros documentados de la familia. | Media: solo documentación comparativa. |
El estilo de argumentos con barra diagonal se asemeja al de la línea de comandos de la familia Trigona/BlackNevas. SentinelOne describe a BlackNevas como un derivado de Trigona con compilaciones compatibles con ESXi y modificadores (switches) especializados, entre ellos /p o /path, /wipe, /depth y /detach. Esa comparación refuerza la atribución, pero no sustituye un hash del binario ni una coincidencia obtenida mediante ingeniería inversa.
Sobrescritura parcial y lo que realmente implican 2 KB
Los artefactos del incidente indicaron que se sobrescribieron aproximadamente los primeros 2 KB de los archivos de disco virtual. El daño al inicio de un disco puede destruir el MBR protector, el encabezado GPT primario y otras estructuras tempranas de arranque o del sistema de archivos, lo que puede impedir de inmediato que un invitado arranque. Sin embargo, la especificación UEFI exige que los medios GPT conserven tanto el encabezado GPT primario como el de respaldo, y los arreglos de entradas de partición, en ubicaciones distintas. Si el GPT primario está dañado y el de respaldo es válido, el software compatible con GPT debe usar el de respaldo, lo que puede ayudar a restaurar el primario. Por lo tanto, una sobrescritura de los primeros 2 KB no demuestra por sí sola que los metadatos de las particiones sean irrecuperables. La recuperación práctica depende de si también se modificaron otros registros de arranque, metadatos del sistema de archivos, estructuras de volumen, descriptores o datos de aplicaciones, y del diseño exacto del disco virtual.
Destruir primero la ruta de recuperación
En el incidente analizado, la infraestructura de respaldo no fue un daño colateral. El atacante deshabilitó la protección antivirus en el entorno de respaldo días antes del ataque principal y, después, detuvo los servicios de respaldo, cifró la infraestructura de recuperación e interrumpió el acceso administrativo antes de la detonación en ESXi. El orden de las operaciones redujo la capacidad de los defensores para restaurar la producción justo cuando más se necesitaba.
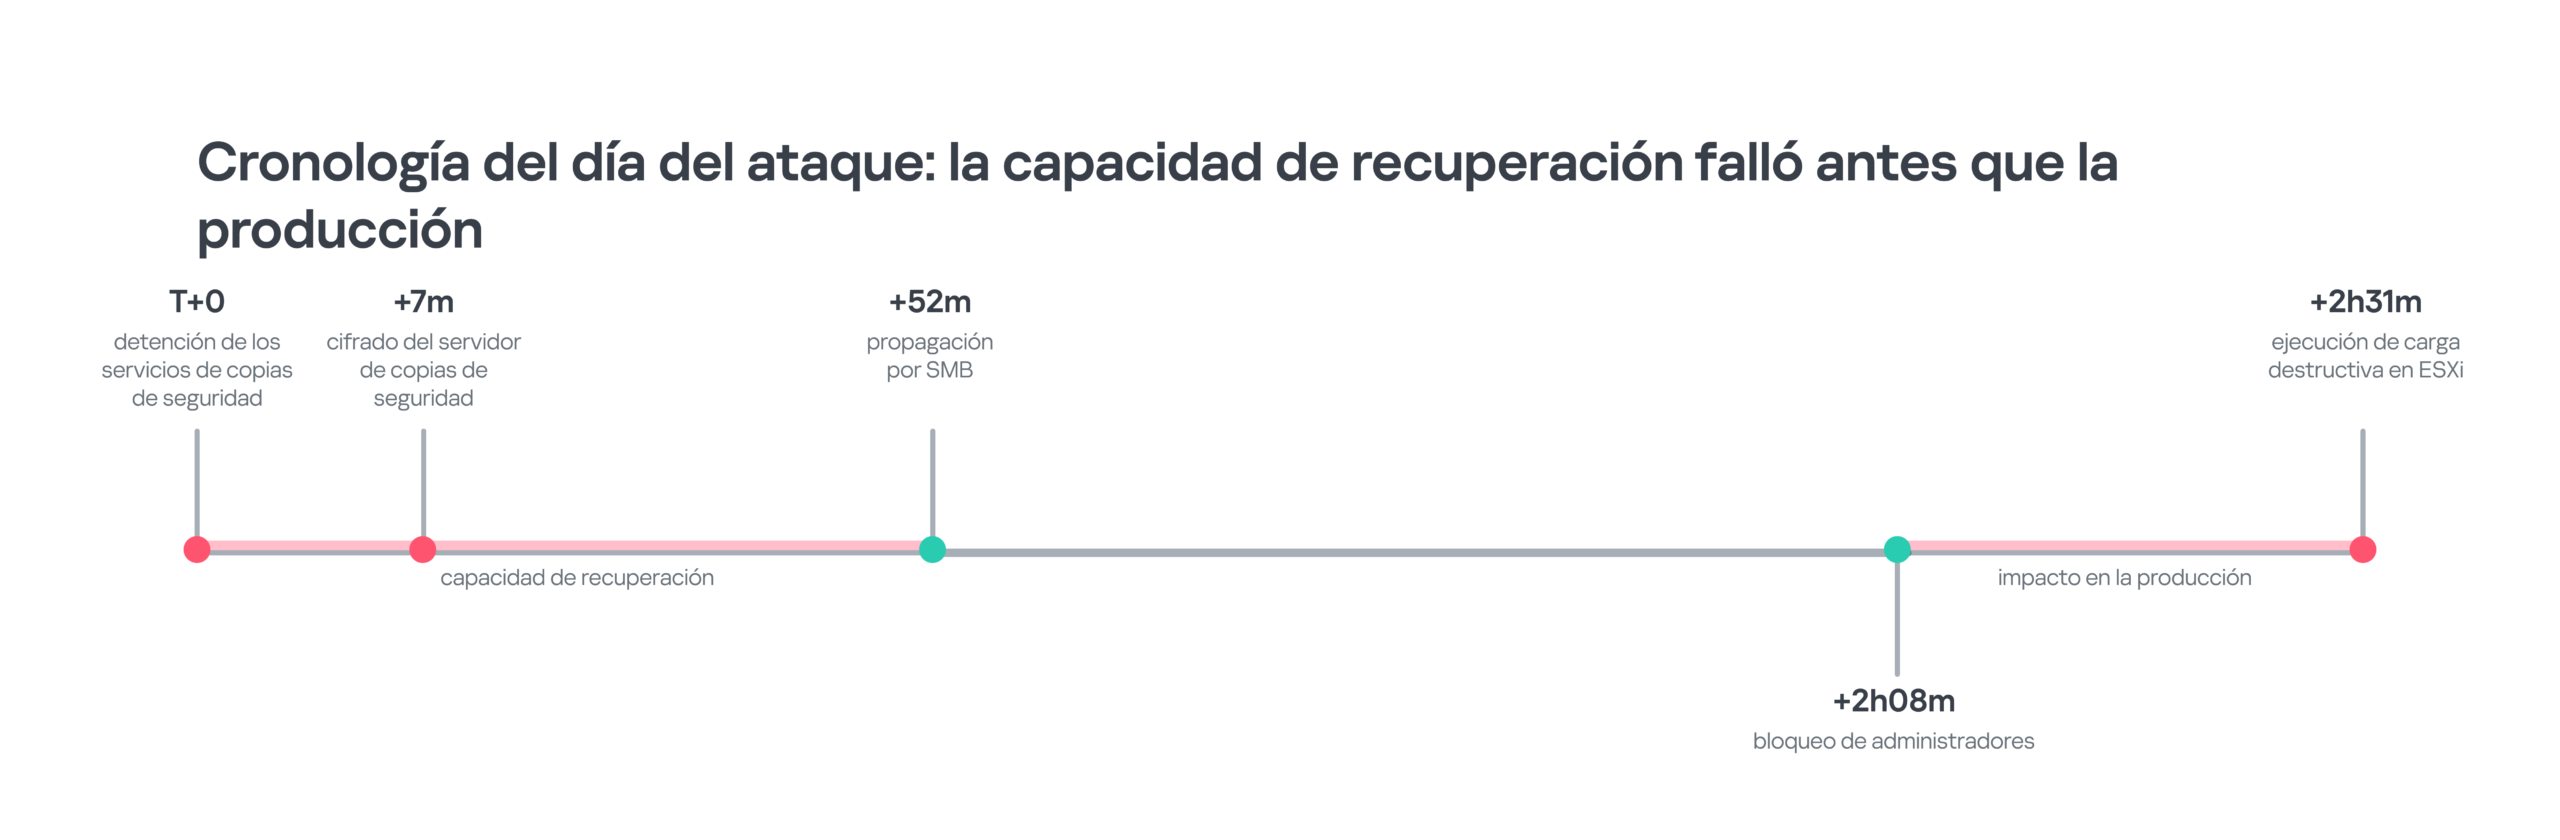
Las capacidades de recuperación se interrumpieron antes del impacto final en ESXi. Los tiempos relativos se basan en la secuencia del incidente
Esto cambia la definición de una arquitectura de respaldo resiliente. La inmutabilidad del almacenamiento es valiosa, pero no protege las identidades, los servidores de administración, los repositorios, las rutas de red, las credenciales ni los procedimientos necesarios para restaurar los sistemas. La recuperación debe diseñarse como un límite de seguridad independiente, con identidades administrativas propias, rutas de administración restringidas, opciones de recuperación sin conexión o aisladas lógicamente, procedimientos de restauración probados y un monitoreo que no dependa del plano de control de producción.
Dos vulnerabilidades recientes en Veeam son una ilustración perfecta de ello. Aunque no se observó la explotación de ninguna de ellas en el caso analizado, aprovechan una política débil de administración de privilegios, lo que puede permitir que cualquier usuario del dominio, incluso los de menores privilegios, las explote. CVE-2024-40711 figura en la base de datos KEV de CISA como una vulnerabilidad explotada por ransomware. CVE-2025-23120 es más reciente y aún no aparece en KEV, pero cabe señalar que, según Veeam, permite RCE, aunque solo afecta a los servidores de respaldo unidos a un dominio. La lección es aplicable independientemente del proveedor: un sistema de recuperación que depende del mismo plano de identidad que la infraestructura de producción puede comprometerse y utilizarse para lograr los objetivos de los atacantes.
Detección e investigación
Existen varios archivos de registro que documentan eventos de ESXi. Estas fuentes permiten reconstruir un incidente destructivo en el hipervisor incluso cuando no hay ningún agente de endpoint en ESXi. La limitación es la retención. Broadcom indica que ESXi registra internamente en un ramdisk, cuyo espacio es limitado y que se borra al reiniciar, y que se requiere un scratch persistente o un syslog remoto si los registros deben sobrevivir a un reinicio y a la pérdida del almacenamiento local. Recomendamos recopilar los registros en un almacenamiento remoto para mantener la visibilidad forense de los incidentes de ESXi.
| Prioridad | Origen | Qué establece | Riesgo de pérdida | Nota de adquisición |
| P1 | auth.log | Autenticación SSH, origen, momento de la sesión, identificadores de cliente | Medio | Reenviar a un destino remoto; preservar antes de la rotación. |
| P1 | shell.log | Todos los comandos de ESXi Shell, además de la habilitación y deshabilitación del shell | Medio | Fuente de comandos de mayor valor. |
| P1 | vpxa.log | Acciones de vCenter del lado del host, incluidos los flujos de trabajo de administración | Medio | Correlacionar con los Events y Tasks de vCenter. |
| P1 | vobd.log | Cambios de estado de servicios, observaciones de seguridad, eventos de execInstalledOnly |
Medio | Evidencia de configuración útil y de alto valor. |
| P1 | vCenter Events / Tasks | Entidad de seguridad (principal), objeto y acción administrativa | Medio | Exportar de inmediato si vCenter sigue disponible. |
| P1 | systemd + sistema de archivos de VCSA | Unidades de persistencia y binarios a los que hacen referencia | Medio | Para /etc/systemd/system y /opt/vmware, validar la configuración actual del sistema de archivos y de los servicios frente al estado aprobado por la organización |
| P2 | vmkernel.log / vmkwarning.log | Almacenamiento, ciclo de vida de los worlds, advertencias del kernel | Medio | Corrobora el impacto y el comportamiento del host. |
| P2 | vmksummary.log | Número de VM en ejecución por hora y heartbeat del host | Medio | Útil para dimensionar el impacto; precisión temporal limitada. |
| P2 | esxupdate.log | Actividad de instalación de VIB / parches | Medio | Crítico si se sospecha una instalación maliciosa de VIB. |
| P2 | vmware.log por VM | Eventos de encendido/apagado y de dispositivos específicos de cada VM | Medio | En riesgo si el datastore se cifra o se borra. |
| P2 | hostprofiletrace.log | Actividad de aplicación / cumplimiento de Host Profile | Medio | Preservar si se sospecha abuso de Host Profile. |
| P3 | fdm.log / vmauthd.log / syslog.log | HA, puerto 902 y contexto general de daemons | Medio | Corroboración útil tras la adquisición de P1/P2. |
Oportunidades de detección de alta confianza
Esta sección ofrece un resumen de las notas de detección conductual más valiosas derivadas del incidente analizado. Las reglas más sólidas correlacionan acciones legítimas en una secuencia anómala, en lugar de alertar sobre un solo comando de administración.
| Detección | Comportamiento | Telemetría | Severidad |
| Host Profile -> TSM-SSH | La remediación de Host Profile cambia TSM-SSH de deshabilitado por política a RUNNING fuera de una ventana de cambio aprobada. |
vCenter Events, vpxa.log, vobd.log | Crítica |
| SSH directo originado desde vCenter | Nueva sesión SSH de vCenter a ESXi tras un cambio en el estado de seguridad. | auth.log + flujo de red | Crítica |
| Nueva unidad de systemd con apariencia de VMware | Unidad nueva o modificada en /etc/systemd/system que hace referencia a un binario fuera de la línea base en una ruta similar a las de VMware. |
Sistema de archivos / auditoría de VCSA | Alta |
execInstalledOnly debilitado |
/User/execInstalledOnly pasa a 0/FALSE o se deshabilita la aplicación en el kernel. |
vobd.log + auditoría de configuración | Crítica |
| Nivel de aceptación reducido | El nivel de aceptación del host se cambia a un nivel menos confiable fuera del mantenimiento. | Configuración de vCenter / ESXi | Alta |
| Secuencia automatizada de sondeos SSH | Sesión solo con true seguida, segundos después, de exec o chmod desde el mismo origen/cliente. |
auth.log + shell.log | Alta cuando se combina |
| Validación del payload | Un ejecutable en /tmp realiza una autoprueba breve y luego accede a /vmfs. |
shell.log | Crítica |
| Detención masiva de VM | Muchas acciones de apagado de VM o de detención forzada de worlds en segundos/minutos. | shell.log, hostd.log, Tasks de vCenter | Crítica |
| Impacto inicial en el respaldo | Los servicios de respaldo se detienen o se deshabilitan los controles de seguridad poco antes de los cambios en el hipervisor. | Telemetría de Windows/respaldo + vCenter | Crítica |
| Artefactos de borrado de datastores | Creación rápida de marcadores de borrado o escrituras destructivas en varios volúmenes VMFS. | sistema de archivos + vobd/vmkernel | Crítica |
Ejemplo de lógica de correlación
A continuación, presentamos un par de ejemplos de lógica de correlación independiente de la tecnología que puede utilizarse para buscar incidentes similares. Cabe señalar que no son reglas de SIEM listas para usar, pero pueden servir para desarrollar reglas propias.
Ejemplo 1: Abuso de Host Profile que conduce al acceso directo a ESXi:
|
1 2 3 4 5 6 7 8 9 |
IF host_profile_remediation changes service in {TSM, TSM-SSH} AND service_state becomes RUNNING within 5 minutes AND no approved change window exists THEN raise HIGH severity; IF SSH session to same ESXi host originates from vCenter or management appliance within 15 minutes of the remediation THEN escalate to CRITICAL and preserve auth.log, vpxa.log, vobd.log, vCenter Events/Tasks and Host Profile state. |
Ejemplo 2: preparación del payload en ESXi previa al impacto:
|
1 2 3 4 5 6 7 8 9 |
IF SFTP upload or new executable appears under /tmp AND chmod / execution follows from same SSH client or source AND a short validation run occurs before access to /vmfs THEN raise CRITICAL; Increase confidence if: - client identifier is unusual for the management segment - repeated true-only SSH channels precede commands - multiple VMs are stopped soon afterward. |
Respuesta a incidentes en la capa de virtualización
Esta sección contiene las acciones recomendadas para responder a un incidente que involucra ransomware en ESXi.
Primeros 30 minutos tras el descubrimiento del incidente
- Aislar el acceso de administración de vCenter de los segmentos empresariales ordinarios, preservando el acceso de los investigadores mediante una ruta controlada.
- Exportar los Events y Tasks de vCenter, los registros de auditoría de SSO, las sesiones activas y las definiciones actuales de Host Profile antes de que los cambios de remediación borren el contexto.
- Recopilar auth.log, shell.log, vpxa.log, vobd.log, hostd.log, vmkernel.log, vmkwarning.log, vmksummary.log, esxupdate.log y hostprofiletrace.log de ESXi de cada host afectado.
- Preservar las rutas de
/etc/systemd/systemy/opt/vmwarede VCSA a las que hagan referencia unidades previamente desconocidas o no aprobadas, el historial de shell, wtmp, los registros de autenticación y copias o hashes de los binarios sospechosos. - Capturar la telemetría del servidor de respaldo, el estado de los servicios, la evidencia del almacén de credenciales y los registros de red antes de reconstruir o rotar las credenciales de la infraestructura.
- Registrar el estado actual de
execInstalledOnly, el nivel de aceptación del host, el estado de SSH/ESXi Shell, Lockdown Mode, la pertenencia al dominio y las asignaciones de permisos de ESXi.
No se recomienda comenzar reiniciando ESXi solo para eliminar una sesión del atacante. La persistencia del registro de ESXi depende de la configuración de scratch y syslog, y un reinicio puede destruir la evidencia que reside en el ramdisk. Antes de aplicar medidas de contención que puedan interrumpir la actividad, se debe confirmar que los registros críticos se hayan copiado o conservado en una ubicación remota, salvo que la gravedad de la situación requiera un apagado inmediato.
Prioridades de contención
- Revocar o rotar las credenciales administrativas comprometidas y eliminar las rutas de acceso controladas por el atacante, pero preservar primero los registros de autenticación y de tareas.
- Deshabilitar el acceso no aprobado a TSM-SSH y ESXi Shell después de recopilar la evidencia; asegurarse de que los Host Profiles u otra automatización no los vuelvan a habilitar de inmediato.
- Eliminar de VCSA los servicios de systemd no autorizados y los agentes de administración remota solo después de crear una imagen o preservar la unidad y los binarios a los que hace referencia.
- Restaurar los ajustes de
execInstalledOnlyy del nivel de aceptación a la línea base aprobada después de determinar que hacerlo no interrumpirá la recopilación de evidencia ni las herramientas críticas de recuperación. - Segmentar o desconectar la infraestructura de respaldo comprometida de la producción y establecer un plano de control de recuperación limpio antes de intentar una restauración a gran escala.
Fortalecimiento de la arquitectura: lecciones del caso
Tratar vCenter como Tier 0
VMware vCenter es más que una simple consola de inventario. Puede tener la autoridad para configurar hosts, administrar identidades, encender VM, aplicar Host Profiles e intermediar el acceso en todo el entorno virtual. El incidente analizado muestra por qué el compromiso de vCenter puede socavar los controles aplicados a través del plano de administración de la virtualización, ya que otorga al atacante privilegios suficientes para configurar hosts, controlar VM y modificar ajustes relevantes para la seguridad en todo el entorno virtual, lo que puede permitir que todo el entorno virtualizado se interrumpa o se destruya en cuestión de minutos.
Recomendamos proteger vCenter con identidades administrativas dedicadas, MFA resistente al phishing mediante la federación de identidades compatible, acceso restringido a la red de administración, sesiones privilegiadas monitoreadas y un monitoreo detallado de las operaciones de cambio en Host Profiles y a nivel de clúster.
Separar las identidades de virtualización de la administración empresarial ordinaria
Evitar la reutilización generalizada de credenciales de administrador de dominio o de estaciones de trabajo para administrar la infraestructura de virtualización. Cuando ESXi está unido a un dominio, se debe aplicar la configuración segura de Active Directory siguiendo las recomendaciones de Broadcom y auditar de forma continua las asignaciones de grupos y los permisos. Cabe señalar que la técnica de atacante Valid Accounts también puede utilizarse en entornos ESXi. Además, como ejemplo de la subtécnica Default Accounts, MITRE menciona específicamente la cuenta vpxuser que vCenter utiliza para administrar los hosts.
Restringir las rutas de administración directa de ESXi
SSH es útil para la resolución de problemas, pero debe considerarse una ruta de administración excepcional y no un mecanismo de acceso habitual para el día a día. La habilitación no autorizada de SSH en hosts ESXi, tanto de forma directa como a través de vCenter, debe detectarse monitoreando los cambios en TSM-SSH y tratarse como un evento sospechoso. Para reforzar aún más los hosts ESXi, se recomienda usar Lockdown Mode cuando sea adecuado desde el punto de vista operativo, de modo que el acceso quede limitado a un conjunto reducido de usuarios autorizados de forma explícita. También se debe aplicar filtrado en la red de administración y una política de aprobación y seguimiento para cualquier cambio, en especial si requiere la habilitación del acceso al shell.
Hacer que la ruta de registro sea independiente del host afectado
El syslog remoto de ESXi y vCenter debe almacenarse en una infraestructura externa al dominio de confianza de la virtualización. El scratch persistente mejora la supervivencia de los registros tras un reinicio, pero la evidencia local aún puede perderse si se destruye el almacenamiento de datos o el host. Se recomienda usar el registro centralizado (por ejemplo, en un SIEM), que debe incluir telemetría de autenticación, shell, administración de hosts, Host Profile y tareas de vCenter. Un registro adecuado debe configurarse antes de que ocurra cualquier incidente, de modo que el equipo de respuesta disponga del panorama completo en caso de emergencia.
Diseñar el respaldo como un límite de seguridad independiente
Usar identidades administrativas independientes para el respaldo, minimizar las dependencias del dominio, aislar los repositorios y las interfaces de administración, proteger las copias inmutables frente a las credenciales de producción y probar la recuperación suponiendo que vCenter y el AD de producción no están disponibles. Un diseño de respaldo debe evaluarse no solo por si los datos son inmutables, sino por si un operador limpio puede autenticarse, llegar al repositorio, validar los datos y restaurar las cargas de trabajo después de que el plano de control de producción se haya comprometido.
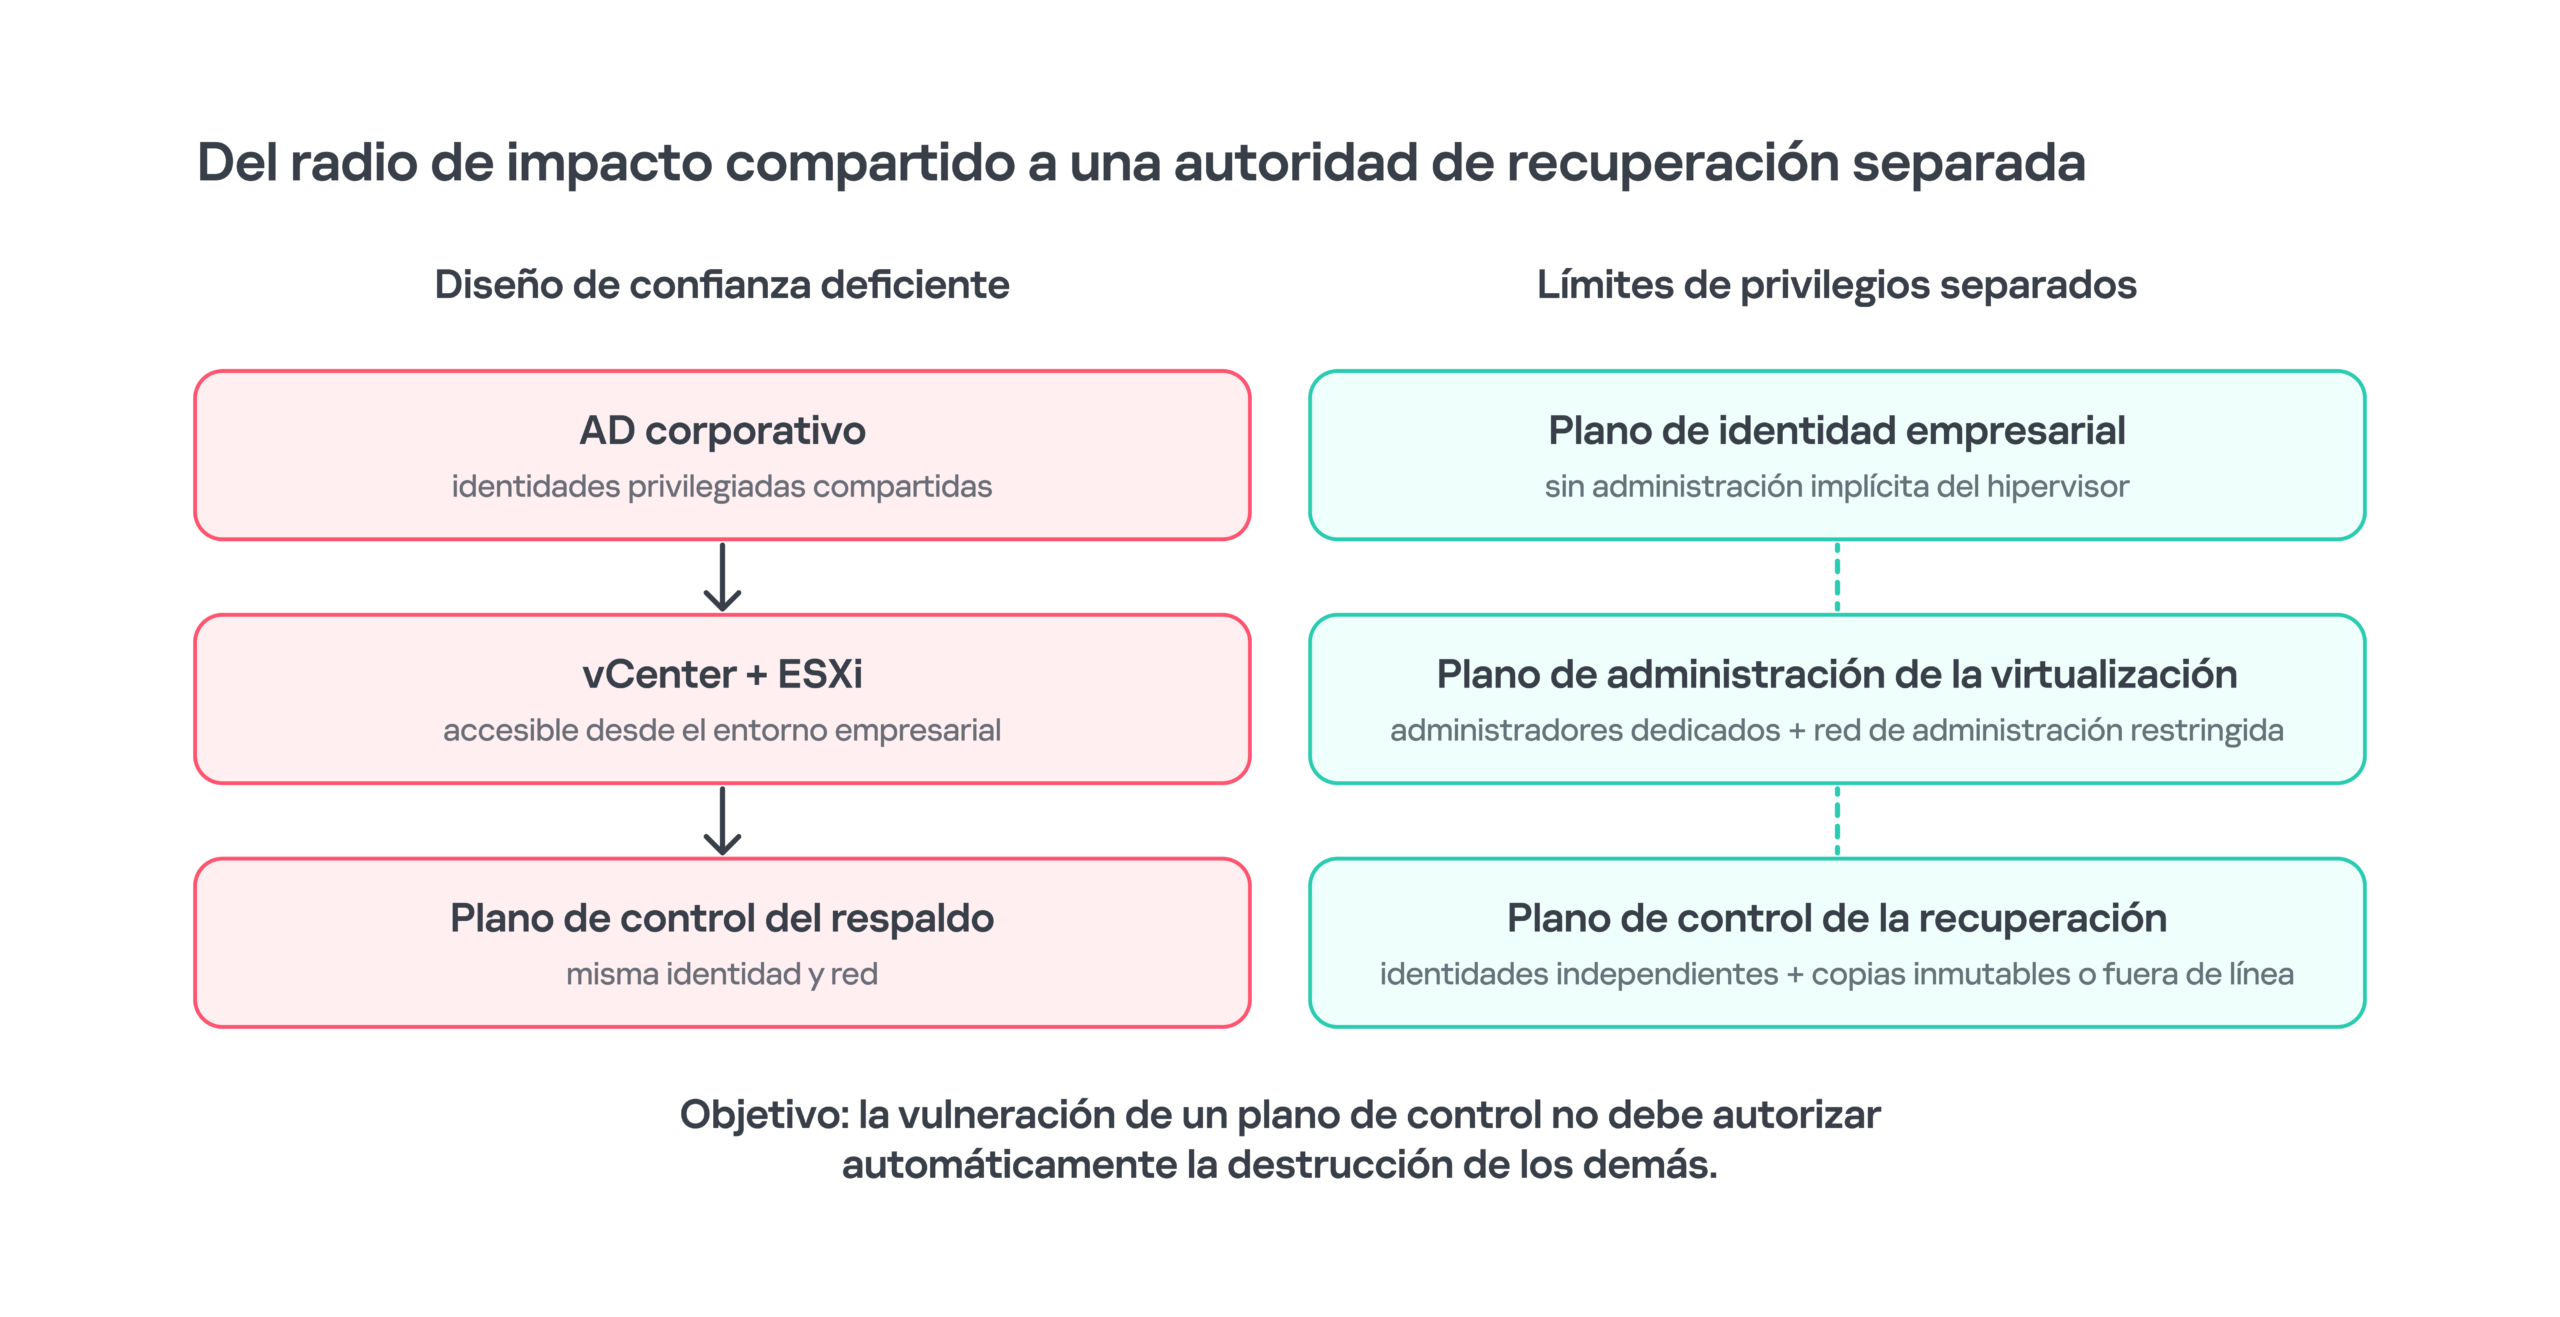
La resiliencia mejora cuando la identidad empresarial, la administración de la virtualización y la autoridad de recuperación están separadas, en lugar de encadenarse mediante credenciales privilegiadas compartidas
Conclusión
La principal lección que nos dejó el incidente analizado no es que ESXi necesite otro agente de endpoint. Es que la seguridad de la virtualización depende a la vez de la integridad del plano de administración, del plano de identidad y del plano de recuperación. Un hipervisor puede mantenerse completamente parchado y protegido, y aun así convertirse en el punto de máximo impacto del ransomware cuando el sistema autorizado para administrarlo ya está comprometido. El adversario no necesitó romper la criptografía de VMware ni escapar de un invitado. Una vez que accedió a un control privilegiado de vCenter, pudo utilizar un mecanismo legítimo de cumplimiento para cambiar el estado del host, habilitar SSH y crear una ruta hacia ESXi cuya estructura se veía similar a las actividades normales de administración.
El caso también muestra por qué los incidentes de ransomware destructivo suelen ganarse o perderse antes de que comience el cifrado. El atacante estableció una persistencia alternativa, validó el payload de ESXi horas antes de la detonación, interrumpió primero la capacidad de respaldo y luego ejecutó actividades disruptivas desde la capa menos visible para los controles del invitado. Cada etapa generó una oportunidad de detección, pero esas oportunidades existían en la telemetría de administración, virtualización y recuperación, y no en un árbol de procesos de endpoint convencional.
Por lo tanto, una defensa eficaz a largo plazo requiere un enfoque arquitectónico. Tratar vCenter como Tier 0. Separar las identidades de virtualización de la administración empresarial ordinaria. Restringir el acceso directo a ESXi. Preservar los registros nativos fuera de la plataforma afectada. Detectar los cambios de configuración de alto riesgo como secuencias y no como comandos aislados. Y diseñar la recuperación de modo que el compromiso de la identidad de producción o de la administración de la virtualización no otorgue también la autoridad necesaria para destruir los sistemas indispensables para restaurarlos.
Mapeo de MITRE ATT&CK
| Técnica | Nombre | Relevancia en el caso | Estado |
| T1078 / T1078.002 | Valid Accounts / Domain Accounts | Credenciales empresariales robadas utilizadas para el acceso privilegiado a la infraestructura. | Observada / contextual |
| T1078.001 | Valid Accounts: Default Accounts | Relevante para las relaciones de confianza de root y vpxuser en ESXi. | No observada en el incidente analizado, pero relevante para la plataforma ESXi |
| T1021.004 | Remote Services: SSH | SSH utilizado para la administración de vCenter y ESXi; MITRE cubre explícitamente SSH en ESXi. | Observada |
| T1543.002 | Create or Modify System Process: Systemd Service | Ligolo-ng persistió como vmware-vdma.service en VCSA. | Observada |
| T1572 | Protocol Tunneling | Ligolo-ng creó una ruta tunelizada hacia el segmento de administración. | Observada |
| T1490 | Inhibit System Recovery | Los servicios de respaldo y la infraestructura de recuperación se interrumpieron antes del impacto en producción. | Observada |
| T1486 | Data Encrypted for Impact | Las cargas de trabajo de virtualización quedaron fuera de servicio durante la fase de ransomware. | Impacto observado |
Indicadores del incidente
Los siguientes indicadores se recuperaron durante la investigación. Son artefactos específicos del incidente, no firmas duraderas de BlackNevas ni de ninguna otra familia de ransomware. Los nombres de servicios, los nombres de archivos, los dominios y la infraestructura de VPS pueden cambiarse o reasignarse. No se dispone de hashes del cifrador de ESXi, del binario de Ligolo-ng, del script instalador del agente ni del script de extracción de credenciales porque esos archivos no estaban disponibles.
| Tipo | Indicador | Contexto | Confianza | Alcance |
| Servicio | vmware-vdma | Unidad de systemd que se hace pasar por un servicio de VMware en VCSA. | Alta | Específico del incidente |
| Servicio | vspbind | Servicio de Windows para el agente de administración remota. | Alta | Específico del incidente |
| Dominio | api.cloudvflare[.]com | C2 de Ligolo-ng; typosquatting de cloudflare.com con un carácter de diferencia. | Alta | Específico del incidente |
| IPv4 | 45.149.154[.]135 | C2 del agente de administración remota. | Alta | Específico del incidente |
| IPv4 | 91.92.242[.]121 | VPS utilizado para el acceso inicial al portal. | Alta | Específico del incidente |
| IPv4 | 31.41.33[.]212 | VPS utilizado para el acceso inicial al portal. | Alta | Específico del incidente |
| IPv4 | 188.240.57[.]94 | VPS utilizado para el acceso inicial al portal. | Alta | Específico del incidente |
| SHA-1 | 28f8da19ddcdf26e426875c7a834b34a79bc1c33 | svhost.exe / lock.exe. | Alta | Específico de la muestra |
| SHA-256 | 15dc419b7fbeb50c50820a7cd27997541deafa4fa710f074bb657f0149574baf | Agente de administración remota. | Alta | Específico de la muestra |
| SHA-256 | 5a9b7a0d3f25757aea957713d7e84cabec87597b3474368328a8fd5ed7a12f78 | Variante instalada del agente de administración remota. | Alta | Específico de la muestra |
Conjunto mínimo de recopilación forense de virtualización
| Capa | Fuente de telemetría | Valor investigativo |
| Autenticación de ESXi | /var/run/log/auth.log | IP de origen, usuarios, momento de las sesiones SSH e identificadores de cliente. |
| Comandos de ESXi | /var/run/log/shell.log | Comandos exactos ejecutados mediante ESXi Shell. |
| Administración de vCenter a host | vpxa.log + Events/Tasks de vCenter | Remediación de Host Profile, cambios de servicios y origen administrativo. |
| Observaciones de seguridad del host | vobd.log | Eventos de execInstalledOnly, de servicios y de estado de seguridad. |
| Administración del host | hostd.log | Tareas de VM y de host, interacciones de API/administración. |
| Kernel / almacenamiento | vmkernel.log + vmkwarning.log | Fallas de almacenamiento, ciclo de vida de los worlds y advertencias de VMkernel. |
| Escala del impacto | vmksummary.log | Número de VM por hora y heartbeat del host. |
| Historial de VIB | esxupdate.log | Instalación de parches / VIB. |
| Host Profile | hostprofiletrace.log | Actividad de aplicación y cumplimiento del perfil. |
| Evidencia por VM | vmware.log junto al VMX | Operaciones de encendido/apagado y de dispositivos de cada VM. |
| Persistencia en VCSA | /etc/systemd/system + binarios referenciados | Servicios y rutas de persistencia no autorizados. |
| Acceso a VCSA | Registros de SSO, registros de autenticación, wtmp, historial de shell | Contexto de autenticación, sesiones y comandos. |
| Capa de respaldo | Registros de aplicaciones + telemetría de Windows + evidencia del almacén de credenciales | Compromiso de la ruta de recuperación y puente de credenciales. |
| Red | Firewall / flujos / proxy / DNS | SSH de vCenter a ESXi, C2, tunelización y pivoteo en el segmento de administración. |


Índice
- Por qué el hipervisor cambia la economía del ransomware
- La asimetría de visibilidad
- Cómo llegan los atacantes a la capa de virtualización
- Explotación de vulnerabilidades
- Integración con Active Directory
- Reutilización de credenciales del entorno Windows
- Infraestructura de respaldo como puente de credenciales
- Persistencia en el plano de administración
- Convertir vCenter en un plano de control ofensivo
- Por qué un cambio de configuración de ESXi mediante vCenter es una falla del límite de confianza
- Oportunidad de detección de alta fidelidad
- Notas sobre el abuso de ESXi: herramientas living-off-the-land y controles que se deben monitorear
- Dentro de la fase de impacto en ESXi
- Detención de las VM antes del impacto
- Entrega del payload y comportamiento de FlowSsh
- Comando de detonación y confianza de la evidencia
- Sobrescritura parcial y lo que realmente implican 2 KB
- Destruir primero la ruta de recuperación
- Detección e investigación
- Respuesta a incidentes en la capa de virtualización
- Fortalecimiento de la arquitectura: lecciones del caso
- Tratar vCenter como Tier 0
- Separar las identidades de virtualización de la administración empresarial ordinaria
- Restringir las rutas de administración directa de ESXi
- Hacer que la ruta de registro sea independiente del host afectado
- Diseñar el respaldo como un límite de seguridad independiente
- Conclusión
- Mapeo de MITRE ATT&CK
- Indicadores del incidente
- Conjunto mínimo de recopilación forense de virtualización
En la misma categoría


Ransomware en la capa del hipervisor: cómo los atacantes abusan de las funciones de ESXi y vCenter